dbt Summit 2026 最速レポート Day2 / Day3
―ガバナンスの欠如がAIを誤らせる―
こんにちは。DATUM STUDIOの永野です。
dbt Summit 2026に参加しています。dbtの年次カンファレンスに参加するのは今年が初めてです。
Day2のKeynoteから始まり、たくさんのセッションが開催されていました。
中には気になるセッションの時間が重なっていたり…どのセッションに参加するか、非常に悩みました。
私は、dbtとSnowflakeを用いたデータプラットフォーム構築の案件に携わることが多いのですが、最近はAI時代の波を感じています。ビジネスユーザーでも自由にAIを利用してSnowflakeでデータ活用をしていきたい、というお話を伺う機会も増えています。
そこで、今回のdbt Summit 2026では数あるセッションの中からdbt×AIエージェントに重点を置いて参加してみました!
中でも印象に残った3つのセッションについて、課題・対策・成果に分けて整理していこうと思います。
なお、以下では「AIエージェントが参照・生成する対象(Semantic Views、Cortex Search Service、agentsなど)」を便宜上「AIオブジェクト」と呼びます。
Ship AI agents like tables: dbt materializations for Snowflake CoWork
最初に紹介するのは、Day2に開催されたUnder Armour社によるセッションです。
同社はデータプロダクトにおいて、dbt×Snowflakeによる成熟したガバナンスプロセス(バージョン管理、自動テスト、プルリクエストなど)を5年以上運用してきました。
課題
しかしAIエージェントを構築する際、SnowflakeのSemantic ViewsはUI上で手動作成されており、バージョン管理・プルリクエストなどのガバナンスプロセスが適用されていませんでした。
この結果、次のような実害が発生したそうです。
- ・フィルター調整のため20個のSemantic Viewsを手動編集する作業が発生
- ・ダウンストリームへの影響が可視化できず、どのエージェントがどのテーブル / ビューに依存しているか把握困難
- ・上流のカラム削除によりSemantic Viewsが破損し、エージェントが誤った回答を返す本番インシデントが発生
(しかもインシデントはビジネスユーザーからの問い合わせで発覚したとのこと。これは焦りますね…!) - ・AIエージェント関連のリソースを手動作成しているため、権限管理においてエンジニアに依頼が殺到
いずれもガバナンスの欠如が起点となっており、その結果としてエージェントの誤回答や運用負荷の増大につながっている点が印象的でした。
対策
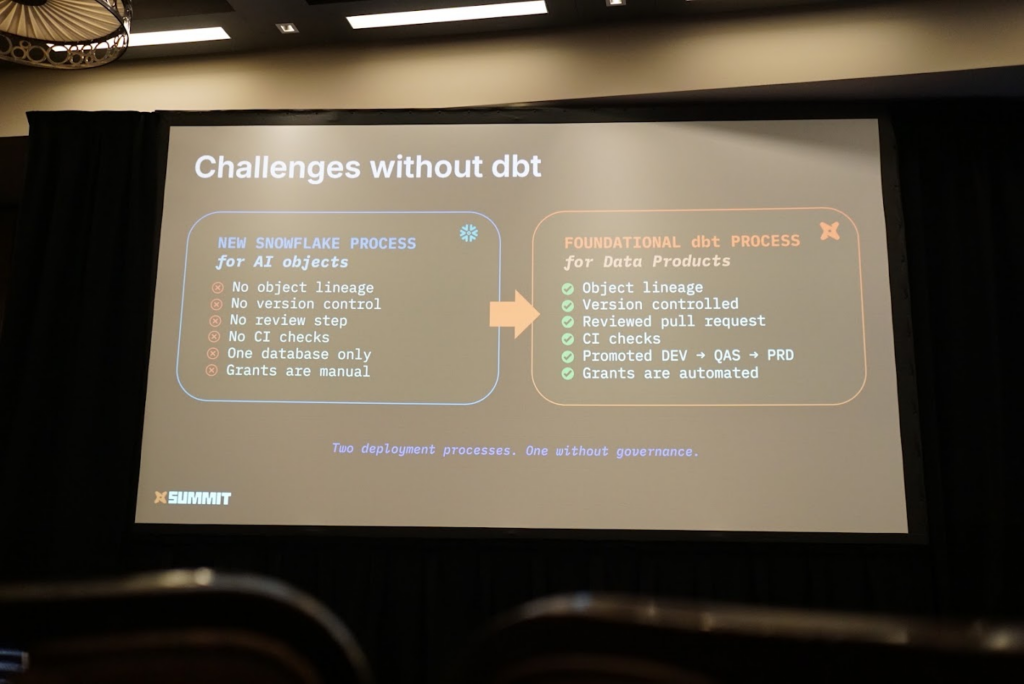
これらの課題を解決するため、以下の3点を実施しています。
(1)dbtにカスタムマテリアライゼーションを定義
SnowflakeのSemantic Views・Cortex Search Service・agentsを、dbtのカスタムマテリアライゼーションとして定義しました。
(2)ref() を用いたモデル定義
(1)で作成したカスタムマテリアライゼーションを用いてAIオブジェクトのモデルを定義します。これによりdbtのref()機能によって、リネージにAIオブジェクトを統合でき、影響範囲を明確にできます。
(3)post-hookによる権限自動化(手動作業の低減)
手動による権限管理をやめ、Snowflakeのロールをベストプラクティスに沿ってアクセスロール / 機能ロールに分離したうえで、dbtのpost-hook機能を用いて、AIオブジェクトへの権限管理を自動化しました。
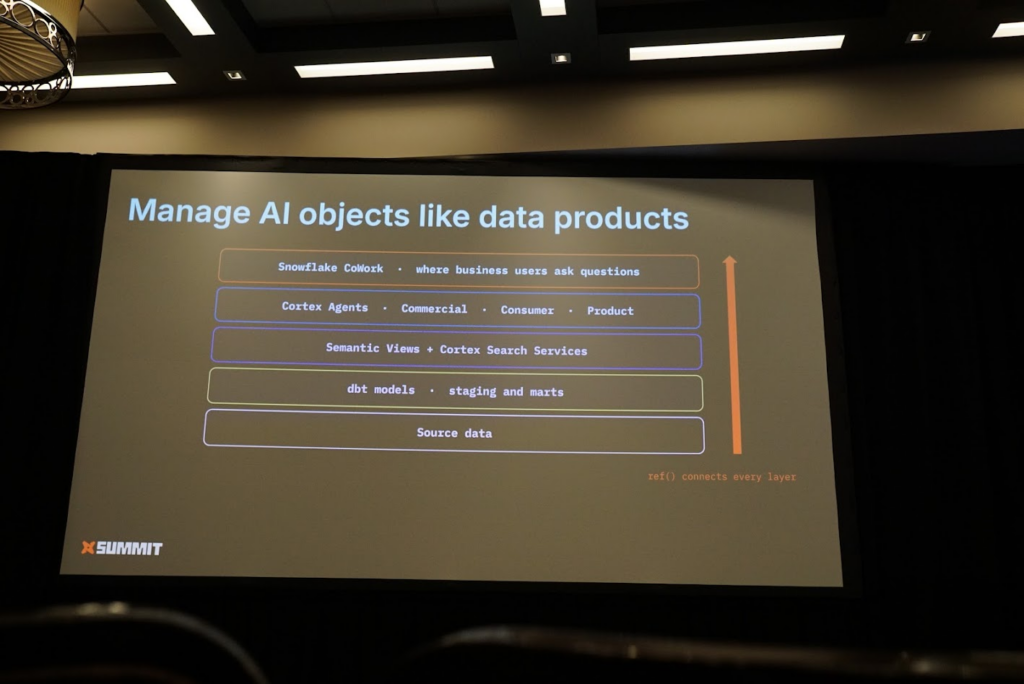
つまりこのアプローチは、AIオブジェクトを外部ツールで別途管理するのではなく、dbt本体の機能拡張によってネイティブに取り込むという方向性です。これらの対応により、AIオブジェクトを既存のデータプロダクトと同じdbtパイプライン内で一気通貫に管理できるようになりました。
成果
上記の対策を実施したことによる成果は以下の通りです。
- ・3つの事業ドメイン・3つのテスト環境にわたり、30以上のCortexオブジェクトが本番稼働
- ・商用エージェントの回答が翌日待ちから即日に短縮
- ・コンシューマーインサイトにおいて、数日かかっていた分析が数秒に短縮
- ・製品チームでは、非構造化ファイルへの自然言語での質問が可能に
How WHOOP bridges dbt models and Snowflake semantic views
2つ目に紹介するのは、Day2に開催されたWHOOP社によるセッションです。
WHOOP社は2012年にハーバード大学発で創業した人間パフォーマンス企業で、人間のパフォーマンスと健康寿命(Healthspan)を最大化するためのウェアラブルデバイスおよびデータ分析プラットフォームを提供しています。
同社も前述したUnder Armour社と同じく、成熟したデータプラットフォームを整備済みです。
課題
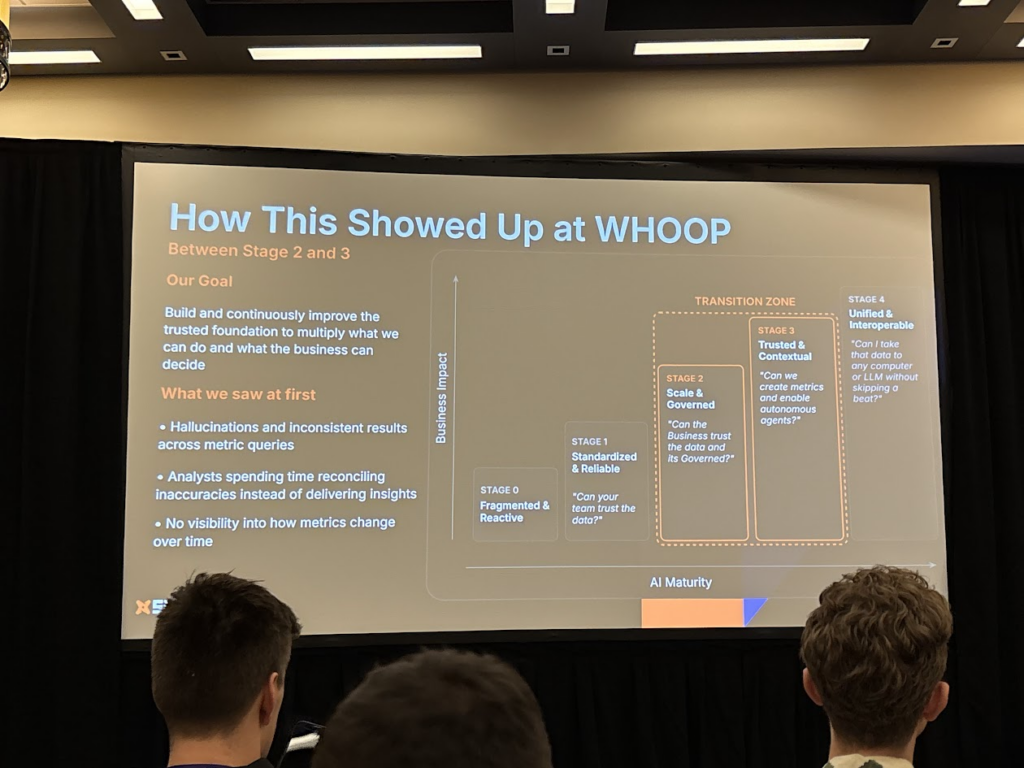
WHOOP社がAIエージェントを導入した際には、以下の課題が発生しました。
- ・AIエージェントがメトリクスに関してハルシネーション(存在しない・誤った情報を生成する現象)を起こす
- ・同じデータを参照しても、タイミングなどによりテーブルの「解釈」や「集計方法」がAIエージェントによって揺れてしまうメトリクスの不整合が発生
- ・メトリクス自体の経時変化を追跡する手段も欠如
この結果、アナリストがその差異を調整するために多くの時間を割く必要が生じていました。本来AIによって効率化されるはずの分析業務が、逆に人手による確認・修正作業を増やしてしまったというのです。
これらの経験から、WHOOP社は「テーブルのガバナンス」だけでは不十分であり、「セマンティクス(ビジネスロジックの意味づけ)そのもののガバナンス」が必要という結論に至りました。
対策
課題の解消に向けて以下の2つを実施しています。
(1)Snowflake Semantic Viewsの採用
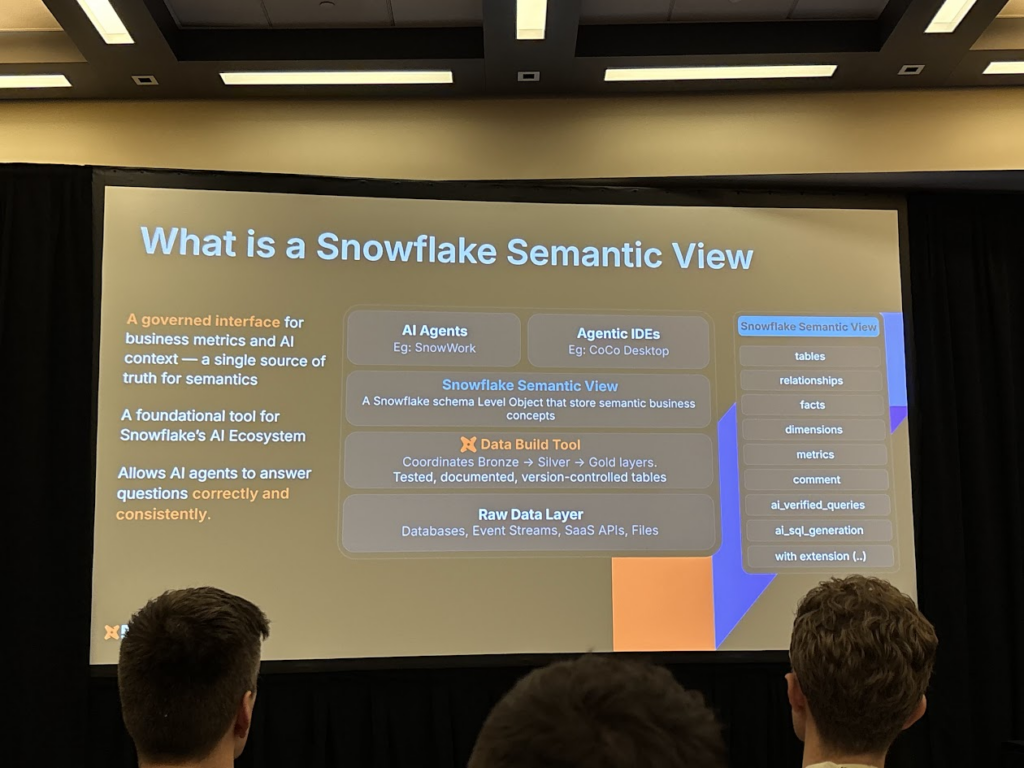
Snowflake Semantic Viewsを、キュレーションされたテーブルとAIツールの間に位置する「インターフェース」として採用することを決定しました。Snowflake Semantic Viewsは、テーブル・リレーションシップ・ファクト列・ディメンション・メトリクスをSQLで定義できる、Snowflake上のスキーマレベルのオブジェクトです。
(2)自社ツールSnowflake Semantic Tools(SST)の開発
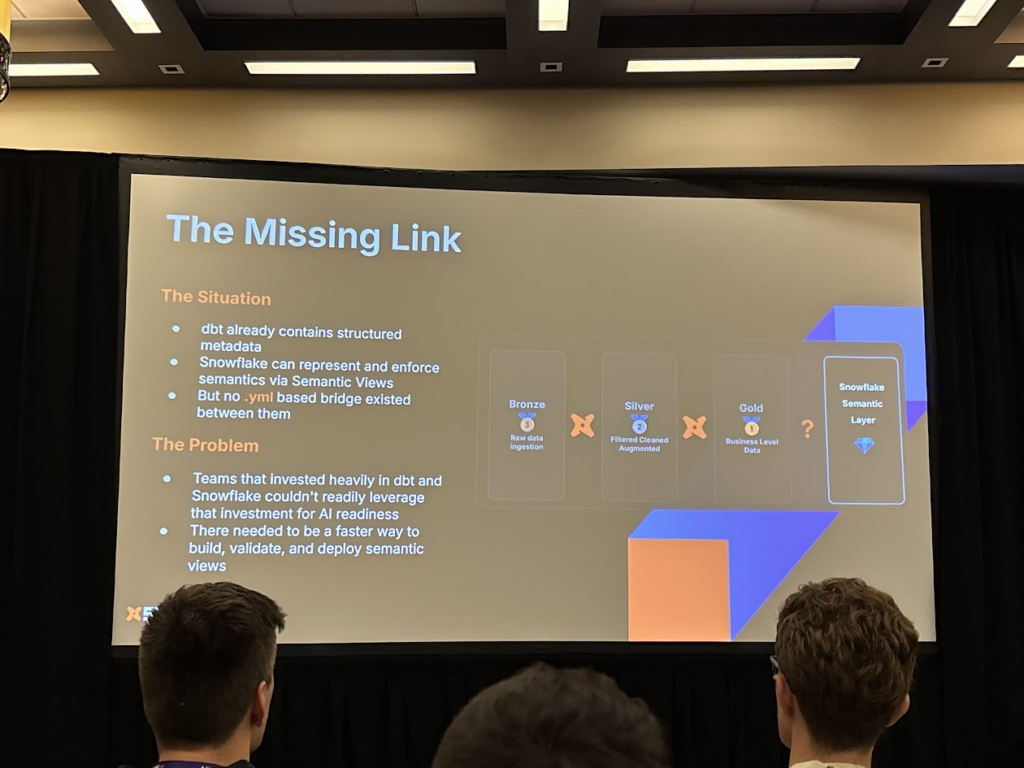
dbtには構造化されたメタデータの蓄積がある一方、それらをSnowflake Semantic Viewsへ連携する仕組み(橋)がなかったため、WHOOP社は自社でオープンソースのPythonパッケージ「Snowflake Semantic Tools(SST)」を開発しました。
なお、前述のUnder Armour社もdbtとSemantic Viewsを繋ぐ独自の仕組みを構築していましたが、そのアプローチは異なります。Under Armour社はdbtのカスタムマテリアライゼーション機能を使ってSemantic Views自体をdbtモデルとして直接管理する方式であるのに対し、WHOOP社はdbtとSemantic Viewsの間に「橋」となる外部パッケージ(SST)を新規開発する方式を採っています。方向性は違えど、両社とも「dbtの構造化メタデータをAIオブジェクトのガバナンスに活かす」という同じ課題意識にたどり着いている点が興味深いです。
ちなみにSSTはGitHubで配布されています。
成果
これらを導入した成果は以下の通りです。
- ・4か月間で80以上のSemantic Viewsをデプロイし、5チーム・50人以上のユーザーが利用。合計1,800件以上のクエリ実行
- ・全てのSemantic ViewsがCortex Analyst対応済みで、セルフサービス分析が可能
- ・分析タスクの所要時間が数日〜数週間 → 約30分に短縮
Governed by default: how data teams at Nordstrom turn dbt governance into an AI advantage
3つ目に紹介するのは、Day3に開催されたNordstrom社のセッションです。
同社のデータ・インサイトチームは150名のデータエンジニア / アナリストで構成され、顧客、マーチャンダイジング、財務、サプライチェーンなど全社の意思決定を支えるデータを提供しています。同社は3年間のデータ戦略を推進しており、その柱は以下の3点です。
- (1)プラットフォーム / ツールのスケーリング(取り込み・変換の高速化)
- (2)信頼できる「ゴールド」データセットの整備
- (3)BIツールの自然言語対応への進化
課題
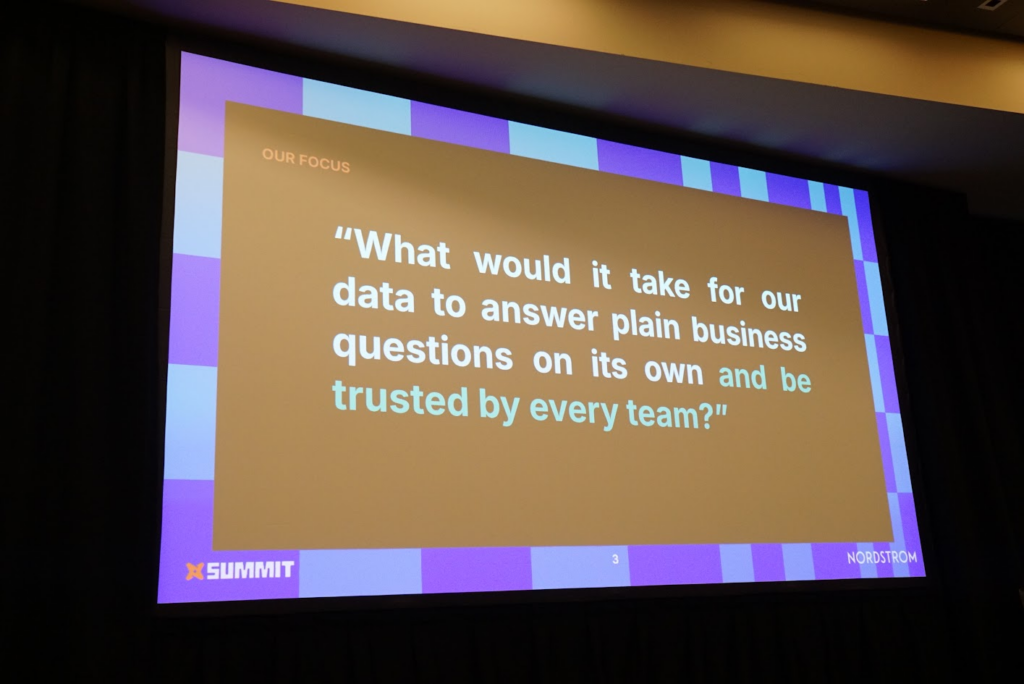
自然言語によるセルフサービス分析を目指す中で、「データが自律的に信頼できる回答を出せるようにするには何が必要か」という問いが、チームにとって最も答えの見えない課題でした。
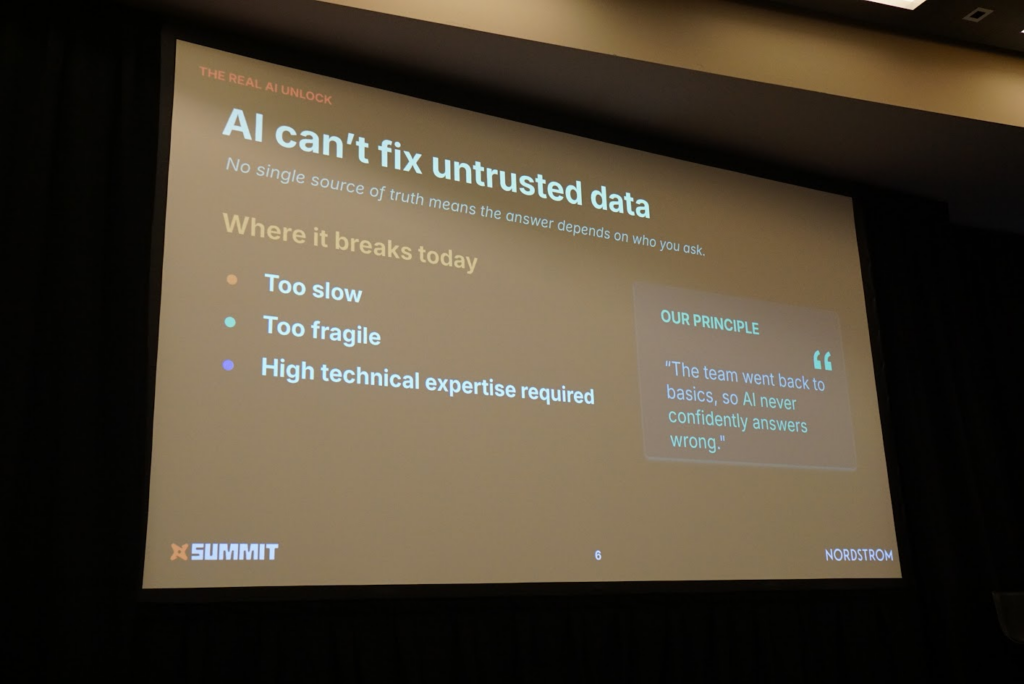
発生した課題としては、以下の2点が挙げられています。
(1)指標定義の食い違い
複数のチームが同じ指標について異なる数値を持ち寄り、何が正しいのかを議論するだけでも時間を浪費していました。
(2)AI導入の失敗事例
未整備のデータにシンプルなAIボットを乗せてみたところ、矛盾した回答をより速く・より多くの人に届けるだけの結果となり、混乱を悪化させました。
ここから「データが速く出ること」自体は解決策ではなく、むしろ「自信満々に誤った回答をする」リスクの方が本質的な脅威だという教訓を得たそうです。
対策
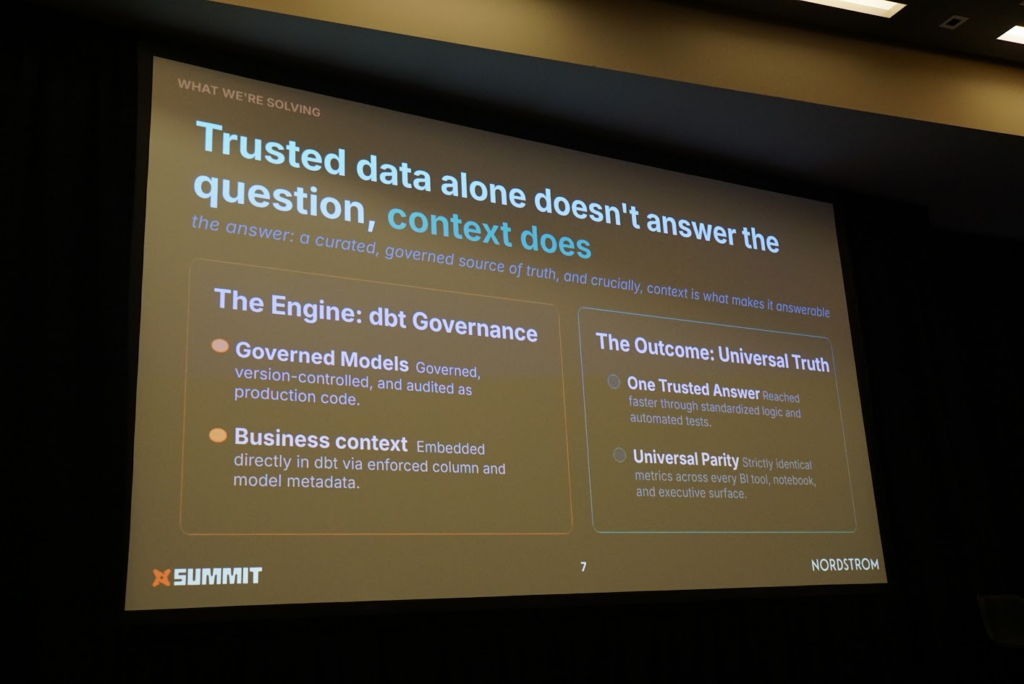
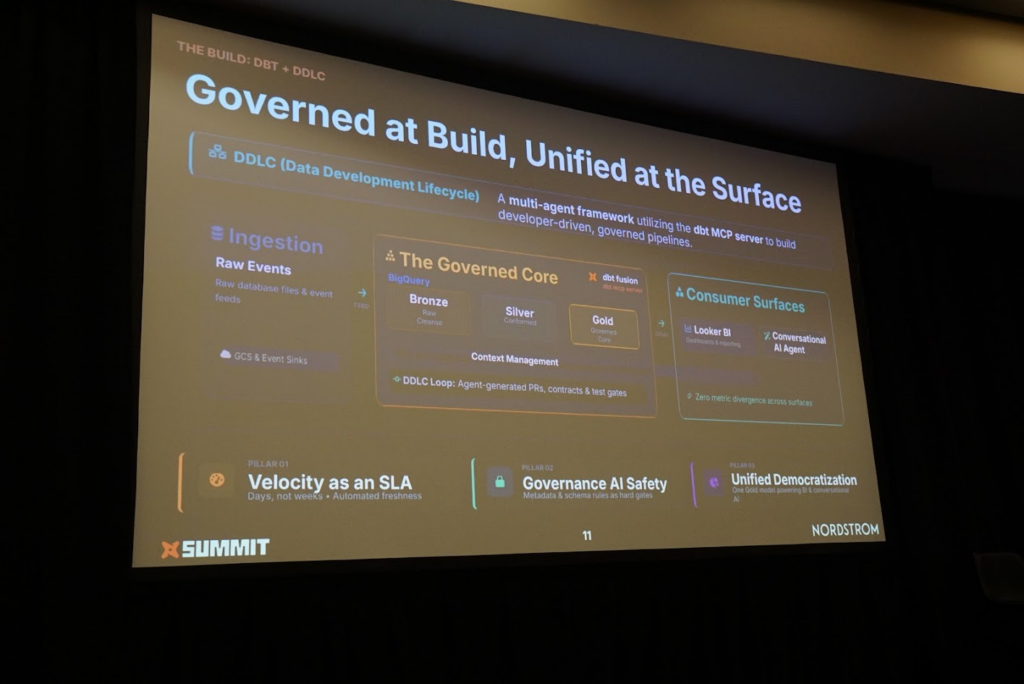
これらの課題に対し、同社はガバナンスを土台にした技術基盤の構築を行いました。
(1)メダリオンアーキテクチャ
BigQuery とdbtを用いてブロンズ層→シルバー層→ゴールド層のモデルを構築。ゴールド層からのみデータを利用する運用に統一しました。
(2)dbtでのコンテキスト管理
カラム / モデルレベルのメタデータ記述をdbt内で必須化しました。
(3)マルチエージェントフレームワーク
dbt MCPサーバー上で、要件理解→モデル構築→検証の3エージェントを連携させ、PRを生成する仕組みを構築しました。
(4)中央集権的コンテキスト管理層
DataHubを基盤に、dbt・Looker のメタデータとビジネス用語集を統合しました。
(5)会話型AIの並行検証
Looker 純正エージェントと自社構築エージェントを比較検討しました。
成果
これらを導入した成果は以下の通りです。
- ・パイプライン開発期間が「週〜月」単位から「日」単位へ大幅短縮
- ・パイロットチームでの利用が2〜5倍に増加
- ・指標の標準化が進み、チームごとに異なる定義の乱立が解消へ
- ・ゴールド層の整備により、AIエージェント向けのデータキュレーションも大幅に迅速化
感想
3つのセッションでは共通しているテーマがいくつかありました。
ガバナンス不足がAIの誤回答リスクに直結する
いずれのセッションでも、よく整備されたデータ基盤の上でも、あるいは基盤が未整備な状態でも、AIエージェントをただ載せるだけでは期待する動作に至らないという共通点がありました。Under Armour社ではガバナンスの欠如がSemantic Viewsの破損や本番インシデントに、WHOOP社・Nordstrom社ではメトリクスの不整合やハルシネーションによる混乱に、それぞれ形は異なりつつも「ガバナンスの欠如がAIの誤動作・誤回答につながる」というリスクが共通して語られていたのが印象的でした。
いずれの会社においても、セマンティックビュー(Semantic Views)やそれに準ずる仕組みの導入に至っていることも印象的でした。データプラットフォームにAIツールを導入する際には、やはりセマンティックレイヤーが必要不可欠な存在になりつつあるのだと実感しました。
セマンティックのガバナンス整備
ただセマンティックビューを導入するのではなく、データが変更されたときの影響範囲まで明確化することが重要であると認識しました。
一緒にdbt Summit 2026へ参加したメンバーからも同じ課題感を持っているというコメントも挙がり、セマンティックビューの導入に当たりこの課題に直面することは多いのだと思います。
私も、もし導入に携わることになったらとても参考になる内容だと思いました。
とはいえ複数の会社で似たような課題に対し、それぞれ異なるアプローチ(dbt本体への統合/独自ブリッジツールの開発)で解決を試みている点は興味深く、そのうちdbt標準として実装されないかなと、ひそかに期待しています…(笑)
データ整備から次のステップへ
いくつかのセッションを通して、データプラットフォームの成熟度はおよそ5つのステップに整理されていると理解しました(セッションによっては4段階で語られている場合もありましたが、本記事ではNordstrom社の5段階モデルに沿って整理します)。
Nordstrom社の資料が個人的に一番好きだったこともあり、引用させていただきたいと思います。
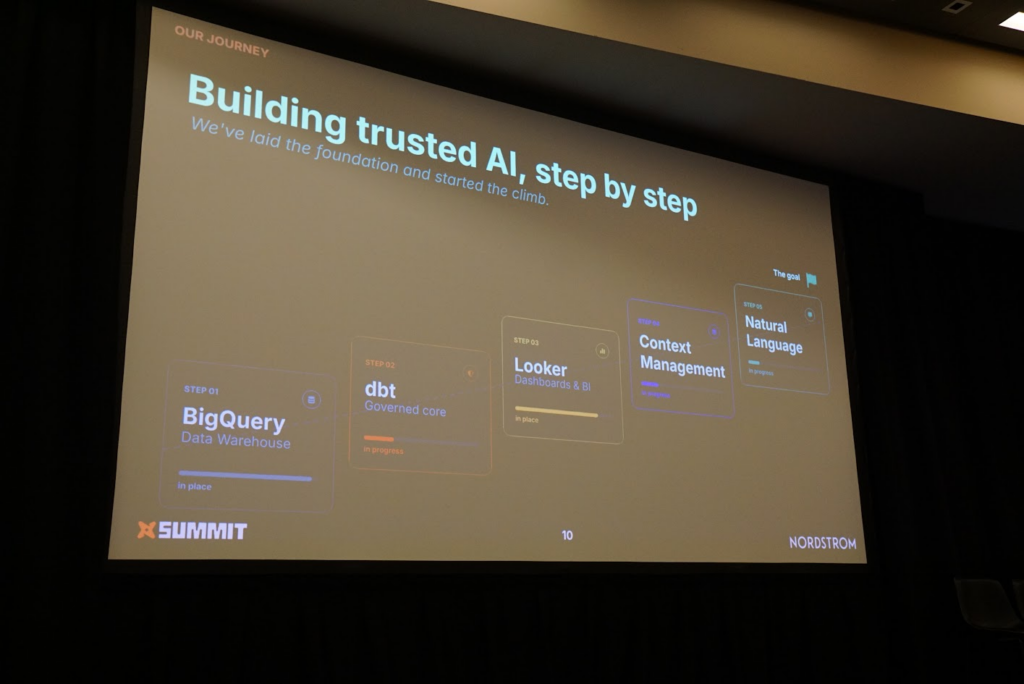
STEP1:Data Warehouse / データウェアハウスにデータを集約
STEP2:Governed core / クレンジング層〜マート層の整備
STEP3:Dashboards & BI / データの可視化・分析
STEP4:Context Management / ビジネスロジックの整備
STEP5:Natural Language / 自然言語によるデータ活用
私が今までやってきたSTEP3までのデータエンジニアリングはすべての下地になるため、とても重要な工程であることを再認識できました。
そこに加えて、STEP4以降にも踏み込んでお客さまの持つビジネス知識とデータを繋ぐデータエンジニアになれるようにキャッチアップを含めて精進していきたいと思いました!
このページをシェアする: