dbt Summit 2026 最速レポートDay2―セッションレポート:「dbt v2」とは何者か?―
こんにちは、DATUM STUDIOの滝本です。
ラスベガスで開催中のdbt Summit 2026では、これからのdbtの展開に期待したくなる発表が数多く行われています。
その中でもKeynote:Level Upでお披露目された「dbt v2」について、dbt LabsのAika Zikibayeva氏による深掘りライトニングトーク「What’s new in dbt v2」がありましたので、その内容を紹介します。
これまでの「dbt Core」「dbt Fusion」と、これからの「dbt v2」の位置づけ
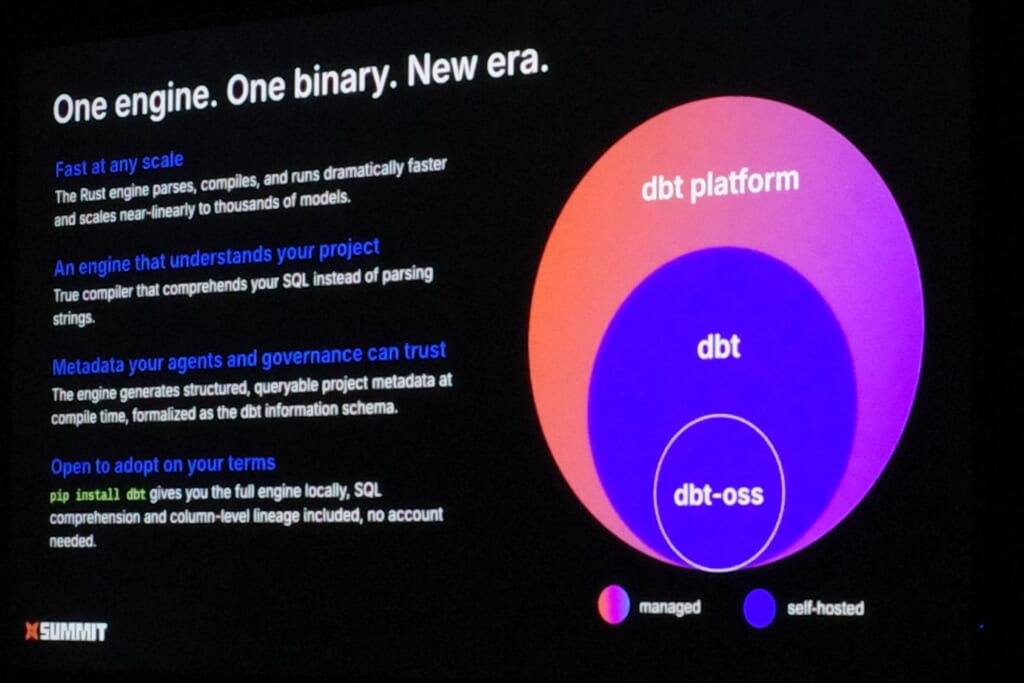
2026年6月の段階で、dbt Coreは「dbt Core v2.0」として、v1.xのPythonベースの実装からRustベースの実装へ装いを新たにすることを発表済みでした。
(dbt FusionもRustベースの実装ですね。)
さらに歩みを進めて、dbt Fusionは「dbt」に、dbt Coreは「dbt-oss」へと改称されました。dbt-oss(旧:dbt Core)の「Apache 2.0 licenseを必要とする場合にのみ使用が推奨される」という、dbt(旧:dbt Fusion)のカウンターパートとしての立ち位置がより鮮明になりました。
SQLFluffがより使いやすく、ビルトインに。「dbt lint」
dbtユーザーで、リンターのSQLFluffをdbtとともに利用されている方は多いのではないでしょうか。
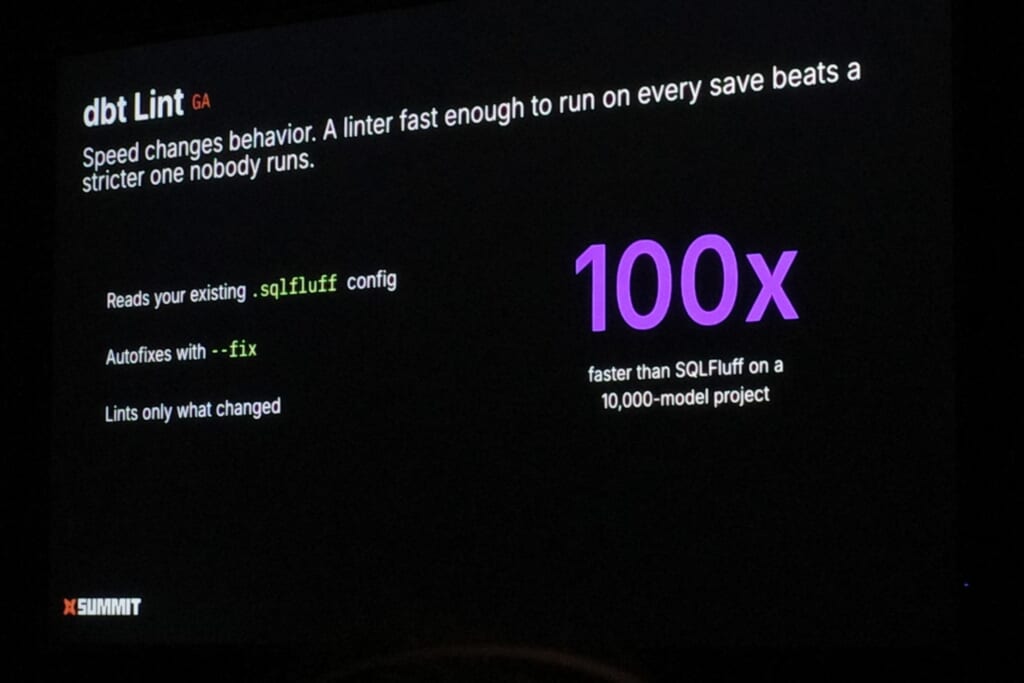
dbt v2では、SQLFluff互換リンターをdbtにビルトイン実装し、かつSQLFluffと比較してとても高速(1万モデル以上を抱えるプロジェクトでは100倍速くなった、という例も)になったそうです。
SQLFluffの設定ファイルである.sqlfluffのような既存の資産もそのまま活用可能ということで、試すハードルも非常に低いものになっています。
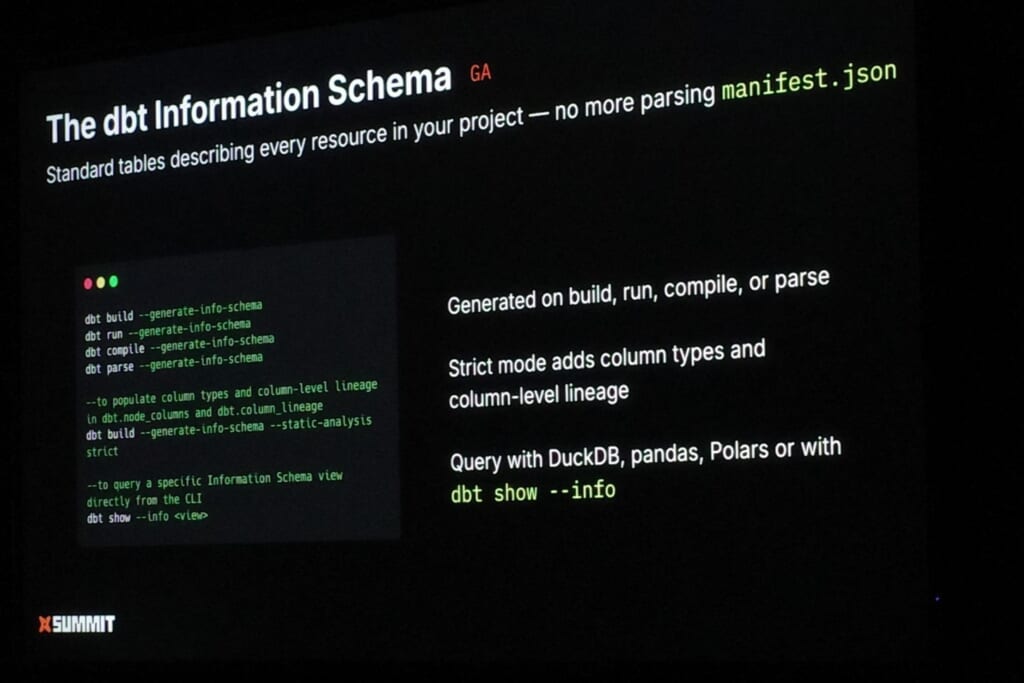
メタデータの大幅な軽量化。「The dbt Information Schema」
dbt Core v1.xでは、buildやparseを行う際に「manifest.json」のようなメタデータファイルが自動生成されていました。
大規模なdbtプロジェクトでよくある話ですが、「manifest.json」はdbtプロジェクトの規模が大きくなればなるほど肥大化し、ファイルサイズが大きくなるだけでなく、これを利用するdbt docsのパフォーマンスにも影響します。
dbt v2ではメタデータファイルの構成を大きく見直し、Parquetファイルを中心にメタデータを提供します。
Parquetファイルで構成されるということは、分析可能でかつパフォーマンスにも優れることを意味します。また、ビルトインのdbt showコマンドを使って分析できます。
メタデータもテストの対象に。「Project quality checks」
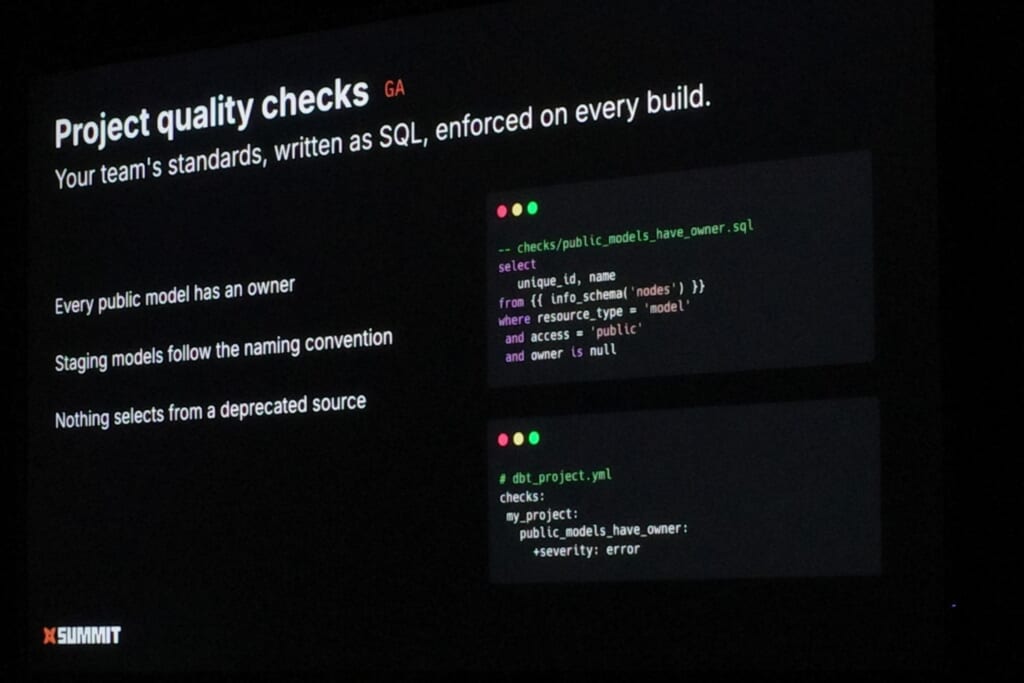
dbtにおけるtestは、モデルのロジックやデータ品質を対象としており、メタデータに対するテストはこれまで存在しませんでした(追加パッケージとして「dbt_project_evaluator」をお使いだった方も多いのではないでしょうか)。
しかしプロジェクトのモデル数が増えるにつれて、「ディスクリプションの記述が漏れているモデルはないか?」「定義されていないタグが付与されているモデルはないか?」といったことを機械的に監視しておきたいケースは多いでしょう。
新たに登場した「Checks」では、書き慣れたSQLで検出ルールを定義できます。
同じモデルのテストはひとつのクエリで。「Batch tests」
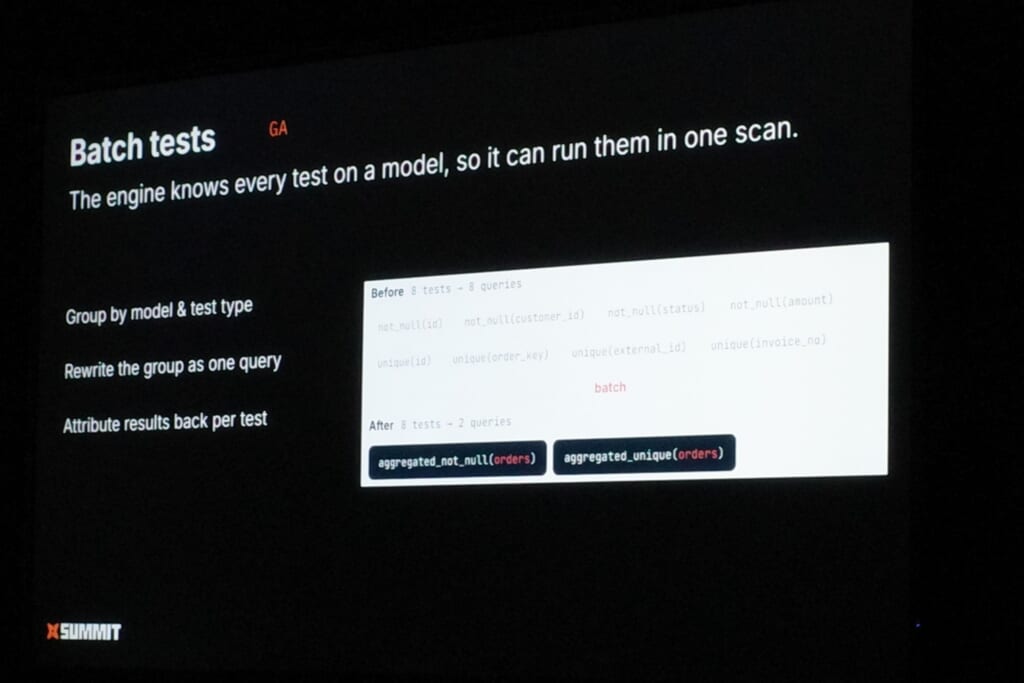
これまでのdata testは、テストひとつにつきクエリがひとつ発行される仕組みでした。
何を当たり前な、と思われるかもしれませんが、一つのテーブル(dbtモデル)に対して複数のテストが存在する場合でも、その数だけ発行されていたのです。
dbtに任せず自分の手で確認用のクエリを書くのであれば、複数の観点を一つのクエリにまとめることも多いのではないでしょうか。
dbt v2で搭載された「Batch tests」は、一つのモデルに含まれる複数のuniqueテストやnot_nullテストを、テストの種類ごとに自動で一本のクエリにグルーピングした上でテスト処理してくれます。
※unique/not_null以外のテストは対象外です。また、グルーピングできるのは同じ種類のテストのみで、severityやwhereなどの設定が入っているテストも対象外となります。対象外のテストは従来どおり単独でクエリが発行されるため、混在していても問題ありません
–batch-testsのコマンドフラグをつけて実行するだけでBatch testsモードになるようなので、気軽に試せるのも嬉しいですね。
テストまでローカル環境で完結。「Unit tests without the warehouses」
dbt Core v1.8で登場したunit testでは、入力値(given)と期待値(expect)を静的に事前定義します。ただし、テストのための計算処理そのものはDWH上で実行する必要がありました。
ユニットテストでは通常、ごくわずかなデータ量でテストを行います。特に、最低課金時間が存在するSnowflakeのようなDWHでユニットテストを実行すると、テスト時間は1秒程度にもかかわらず課金されるのは1分単位になってしまうなど、決して相性の良いものではありませんでした。計算リソースを取り合ってしまい、本番ワークロードのパフォーマンスに影響することもあるでしょう。
dbt v2で新たに登場したLocal unit testsでは、ユニットテストの実行オプションとして、ローカルマシン上のDuckDBを用いてテスト処理を実行することができます。
(初回実行時のみ、上流スキーマ情報を取得するためDWHに接続するようです。2回目以降はキャッシュされた情報を使うため、DWHには接続しません)
小規模な計算はDWHの手を借りずにローカルで完結させ、DWHには大規模な計算に集中してもらう。
マルチプラットフォーム対応を進めるdbtらしい新機能といえるでしょう。
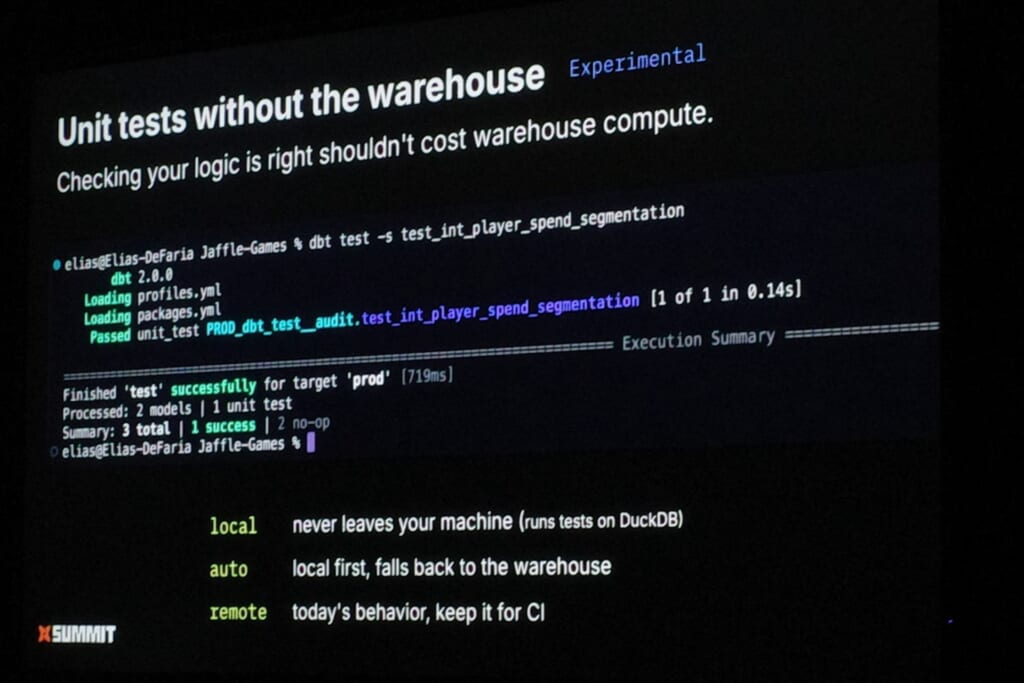
なお、Local unit testsは本記事公開時点で「experimental feature」、アルファ版のもう一歩手前の開発段階にある機能です。また、現段階ではSnowflakeとBigQueryにのみ対応しています。
本番環境での利用は推奨されていませんので、ご注意ください。
まとめ
dbt Summit 2026でお披露目された「dbt v2」は、「The dbt Information Schema」のような抜本的な見直しもあれば、「Unit tests without the warehouses」や「Batch tests」のような痒い所に手が届く機能もあり、実際に利用してみるのが楽しみなリリースとなりました。
これからのdbt v2のレベルアップにも期待したいと思います!
このページをシェアする: