dbt Summit 2026 最速レポート Day2
セッションレポート:海外企業に学ぶ「AI×データ基盤」の最前線
こんにちは、ちゅらデータのtadaken3です。現在、ラスベガスにて開催されているdbt Summit 2026に参加しています。dbt Summit 2026は、9月15日(火)〜9月18日(金)の間、各国のデータエンジニア、アナリティクスエンジニアが集まるdbt Labsの年次カンファレンスです。
詳細はこちら:https://www.getdbt.com/dbt-summit
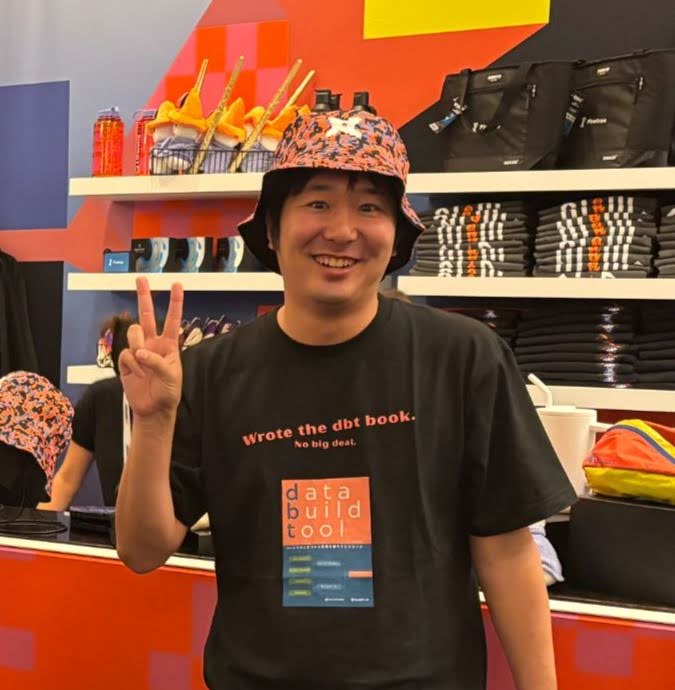
海外のTechカンファレンスに初めて参加したのですが、dbt Labsのコミュニティの熱気をとても感じますね。私も負けじと全身dbtコーデに身を包んでおります。
本日はDay2ということで、Keynoteとセッションがたくさん開催されていました。dbt Labsのセッションもあれば、dbtを利用している企業によるセッションもあり、見たいセッションが目白押しです。私は主にdbtを利用している企業の事例を中心にDay2のセッションに参加しました。
本記事では、気になったセッションを3つご紹介します。
How Fanatics manages dbt metrics with Snowflake CoCo for natural language analytics
タイトルを翻訳すると「Fanaticsがdbtメトリクスを管理し、Snowflake CoCoによる自然言語分析を実現する方法」です。
Fanaticsは、コマース、コレクティブル、イベント、スタジオ、ベッティング&ゲーミングなど幅広い事業を展開する企業です。今回登壇したのは、その中でもベッティング&ゲーミング部門(Fanatics Betting & Gaming)のChristine Kwon氏(Senior Director, Data)とBrett Pendleton氏(Analytics Engineering Manager)のお二人でした。
セッションは、Fanaticsがわずか5年という短期間で、オンラインスポーツベッティング、オンラインカジノ、予測市場(prediction markets)、さらには中東・カナダへの国際展開まで、驚異的なスピードで事業を拡大してきたというストーリーから始まりました。しかしその急成長の裏で、データ基盤が事業のスピードに追いつけず、深刻な「メトリクスの混乱」が発生していたそうです。
セッションでは、この課題を3つのフェーズで解決していったプロセスが紹介されました。
Phase #1:dbtによるメトリックスの標準化
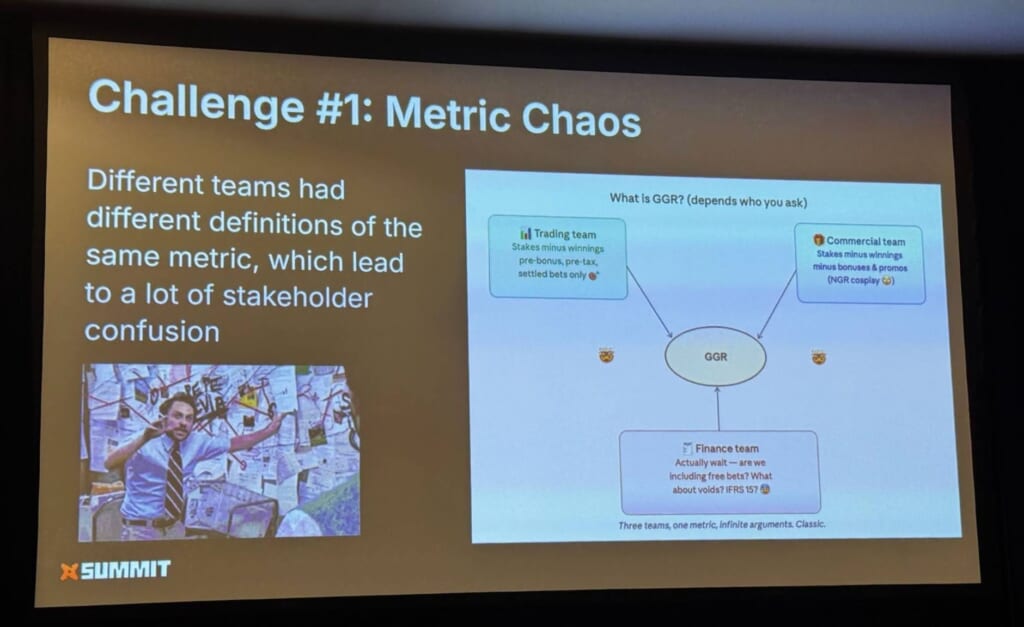
チームごとに「GGR(粗ゲーミング収益)」の定義がバラバラで、トレーディングチーム・ファイナンスチーム・コマーシャルチームがそれぞれ異なる数字を主張するという「メトリクスの混乱(Metric Chaos)」が発生していました。これはあるあるですね。
これに対し、Bronze / Silver / Goldのメダリオンアーキテクチャをanalytics engineering内に構築し、メトリクスの定義をBIレイヤーから完全に排除。dbt platformを使ってデータ変換・オーケストレーション・カタログ化を一元管理することで、単一の信頼できる情報源(single source of truth)を実現しました。
Phase #2:Snowflake CoCo(旧:Cortex Code)による開発の高速化
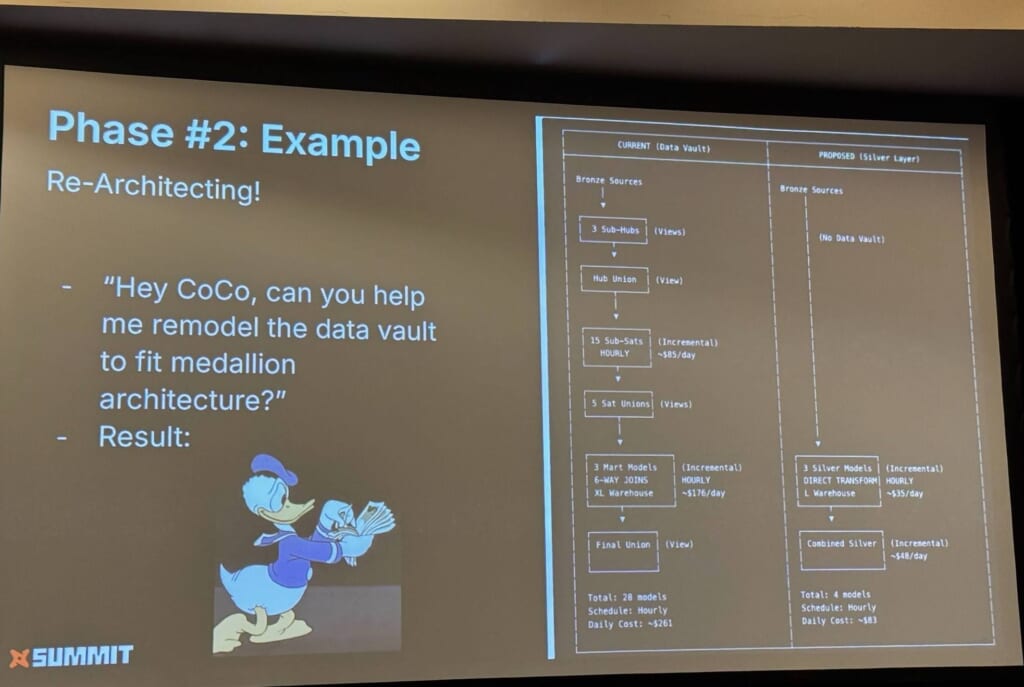
急成長に伴う開発スピードの課題(手動プロセス、テスト不足、ドキュメント不備)に対しては、SnowflakeのAIコーディングアシスタント「Snowflake CoCo」を活用。Gitリポジトリ・Snowflakeスキーマ・dbtプロジェクトの全体コンテキストを把握したSnowflake CoCoが、bulk changesやアーキテクチャの再設計を高速に実行し、その結果、あるケースでは、28個のデータモデルを4個に集約、日次コストを約261ドルから約83ドルまで削減したそうです。
Phase #3:自然言語分析の実現
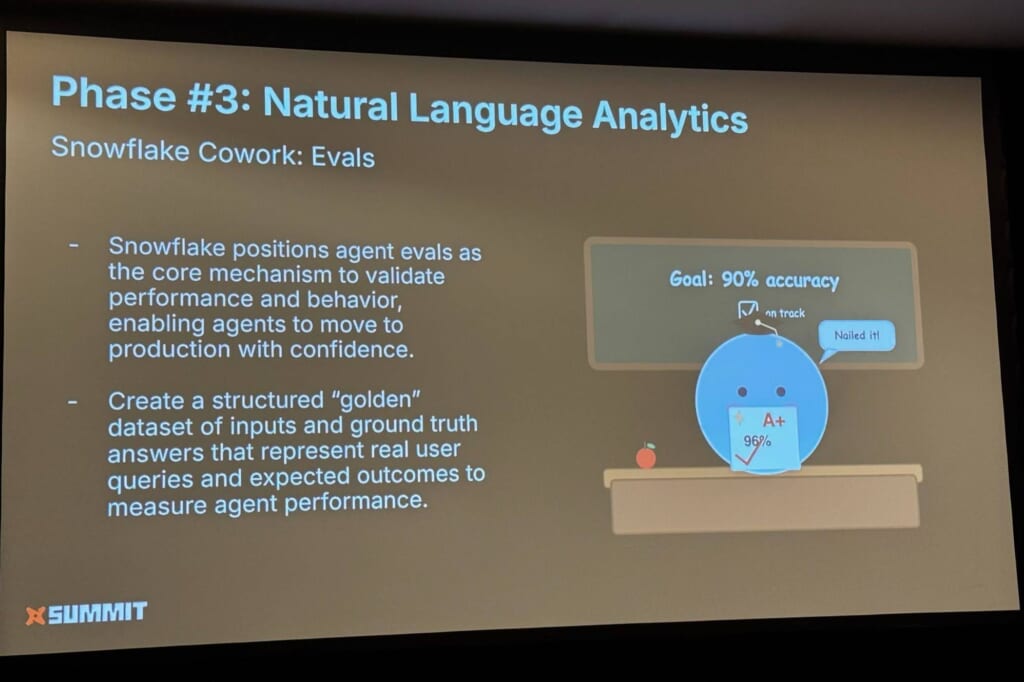
最後に、整備されたデータ基盤の上にSnowflake CoWork(旧:Snowflake Intelligence)とCortex Agents、Snowflake Semantic Layerを組み合わせ、ステークホルダーが自然言語で質問し、信頼できる回答を得られる仕組みを構築。エージェントの応答品質はeval(評価)によって継続的に検証し、90%以上の精度を目標に運用しているとのことでした。
登壇者が強調していたポイントは非常にシンプルで、「AIファースト」でいきなり自然言語分析に飛びつくのではなく、まずメトリクスをきちんとガバナンスし、データをビジネスの実態に合わせてモデリングすることが先決だという点でした。
データ基盤が整っていない状態でAIを導入しても、返ってくる答えの数字が一致せず、結局アナリストがそのしわ寄せを受けることになると。逆に、dbtでデータ基盤、データモデリングをきちんと行うことで、AIは大きな力を発揮してくれる、というのが今回のセッションの核心的なメッセージでした。このセッションのメッセージには、非常に共感しました。
What changes when 300 dbt users at Virgin Media O2 move to Fusion and dbt State
タイトルを翻訳すると「300人のdbtユーザーを抱えるVirgin Media O2がFusionとdbt Stateに移行すると何が変わるのか」です。
Virgin Media O2は、イギリス国内で一般家庭や企業向けにブロードバンドインターネット、有料TV、固定電話、モバイル通信サービスを提供する総合通信事業者です。
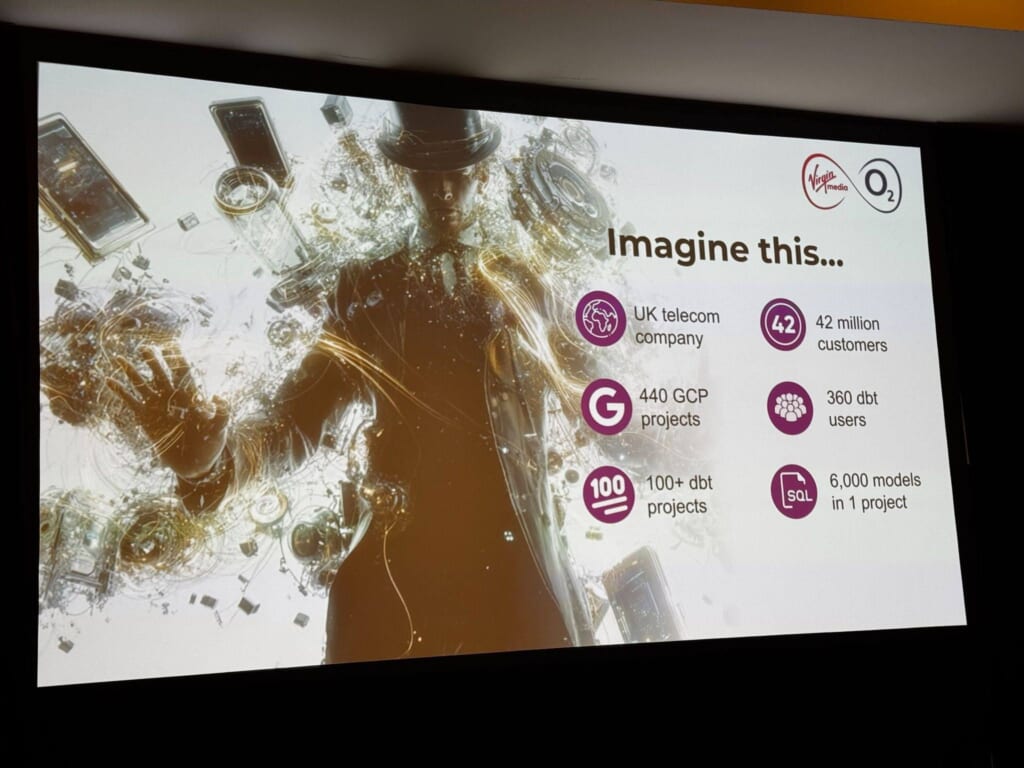
Virgin Media O2は、4,200万人の顧客、100件以上のdbtプロジェクト、6,000モデルを抱える1つのdbtプロジェクトなど、まさに「スケールの塊」のような環境でdbtを運用しています。年間のコンピュート費用も数百万ドル規模とのことで、このスケールになると「非効率」は単なる不便ではなく、そのままコストに直結してしまいます。
登壇したのは、Lead Analytics EngineerのMelissa Simpson氏と、Head of Analytics EngineeringのGordon Curzon氏のお二人。「プロダクトデモではなく、私たちのストーリーを話しに来た」という言葉の通り、実体験に基づいたリアルな内容が印象的なセッションでした。
移行前の課題:待ち時間という「見えないコスト」
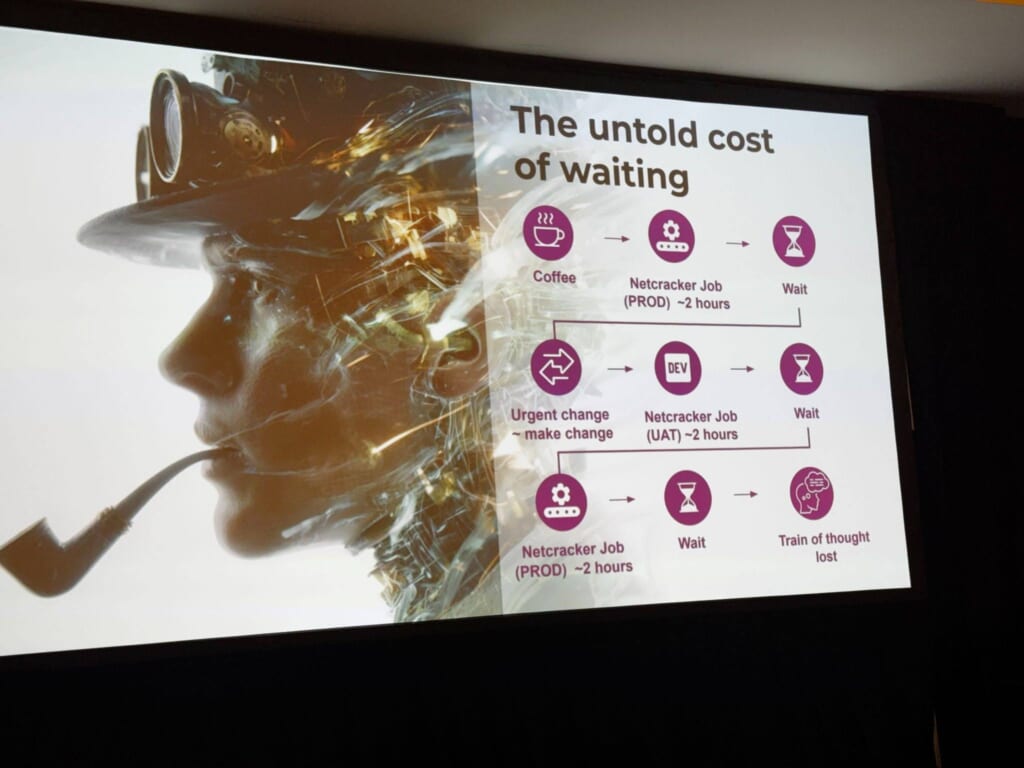
これまでのdbtはステートレス(状態を持たない)な仕組みだったため、ちょっとした修正をするだけでも、モデル全体を毎回ビルドし直す必要がありました。1つの変更を検証環境(UAT)で流すのに2時間、それを本番環境に反映するのにさらに2時間。待っている間に、当初考えていたことを忘れてしまう…という「思考の分断」も、地味に大きな損失だったそうです。
こうした課題は、SpotifyやUber、Netflixなど大規模にデータ基盤を運用する他社でも共通して起きているとのことで、スケールが一定を超えると誰もがぶつかる壁だと紹介されていました。
dbt Fusion(dbt v2)とdbt Stateがもたらす3つの柱
このセッションでは、dbt Fusion(※)がもたらす変化を、3つの柱として紹介していました。
※Keynoteで「dbt v2」という呼称になることが発表されました。Keynoteの内容については、淡島のレポートも、ぜひご覧ください。
▼dbt Summit 2026 最速レポートDay2―Keynoteを聞いてきました―
https://datumstudio.jp/blog/dbt-summit-2026-dailyreport-day2-1/
- 1.State:
前回の実行結果を記憶し、「必要なものだけ」を再実行する仕組み。これまでのように毎回すべてを作り直す必要がなくなります。 - 2.Static Analysis:
コードを書いている最中に、リアルタイムでエラーや影響範囲を検出。CI/CDの実行を待たずに問題を発見できます。 - 3.Developer Experience:
IntelliSenseによる自動補完、LIVE CTEプレビュー、変更前後の比較機能など、日々の開発体験を底上げする機能群です。
気になる効果は?
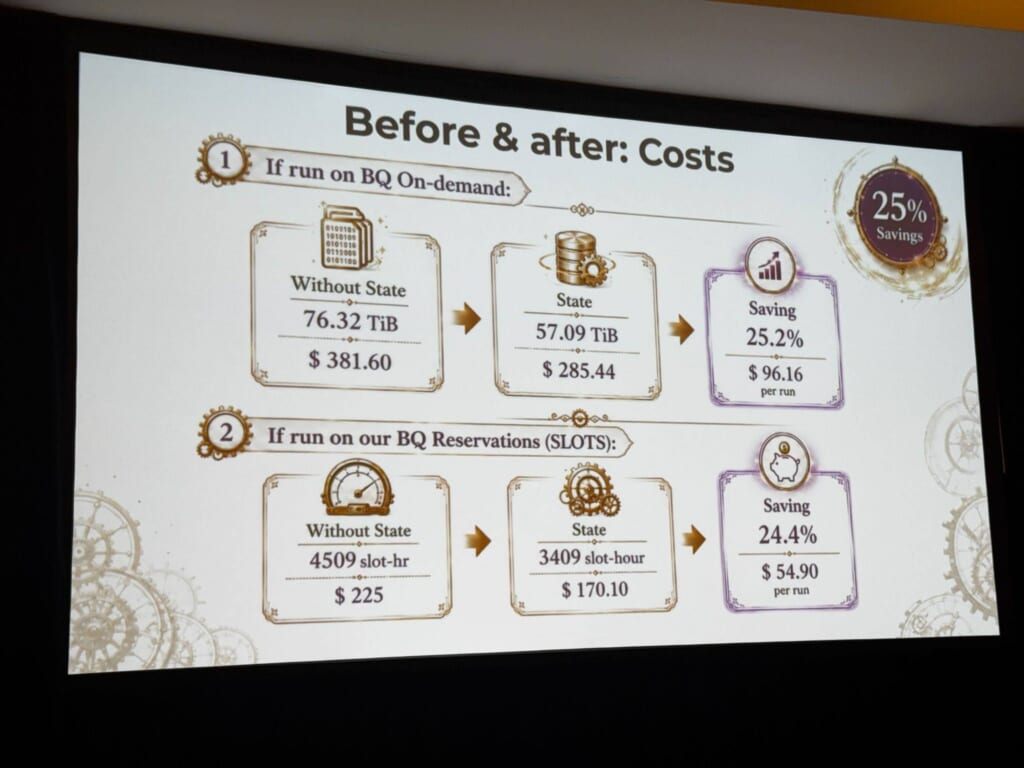
実際に1,400以上のモデルを含むジョブで検証した結果が紹介されており、
- ・実行時間:1時間52分 → 1時間13分(35%短縮)
- ・コンピュートコスト:約25%削減
という、かなりインパクトのある数字が出ていました。
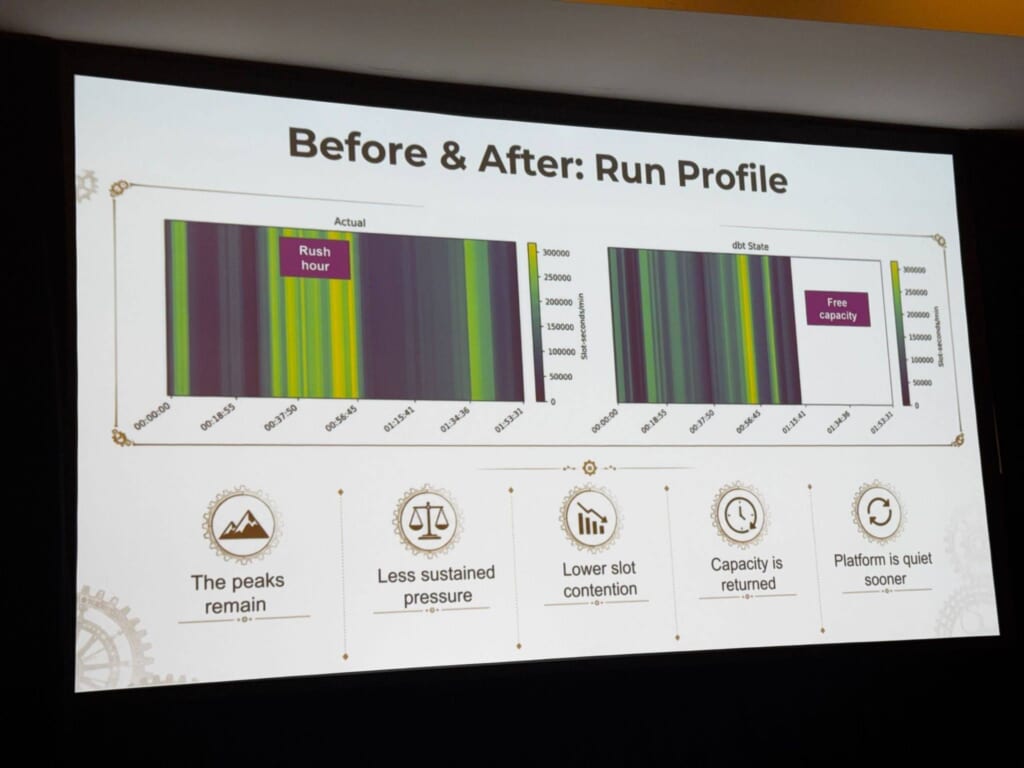
ヒートマップを使った可視化も面白く、ピーク時間帯の負荷が「短時間で収まる」ように変化している様子がひと目でわかる内容でした。
移行は決して平坦な道のりではなかった
一方で、「全部が完璧だった」という話ではなく、既存のカスタムマクロがFusion環境でうまく動かなかったり、独自に構築していたFinOpsの仕組みとの整合に今も苦労していたりと、地に足のついた「移行の生々しさ」も率直に語られていたのが印象的でした。
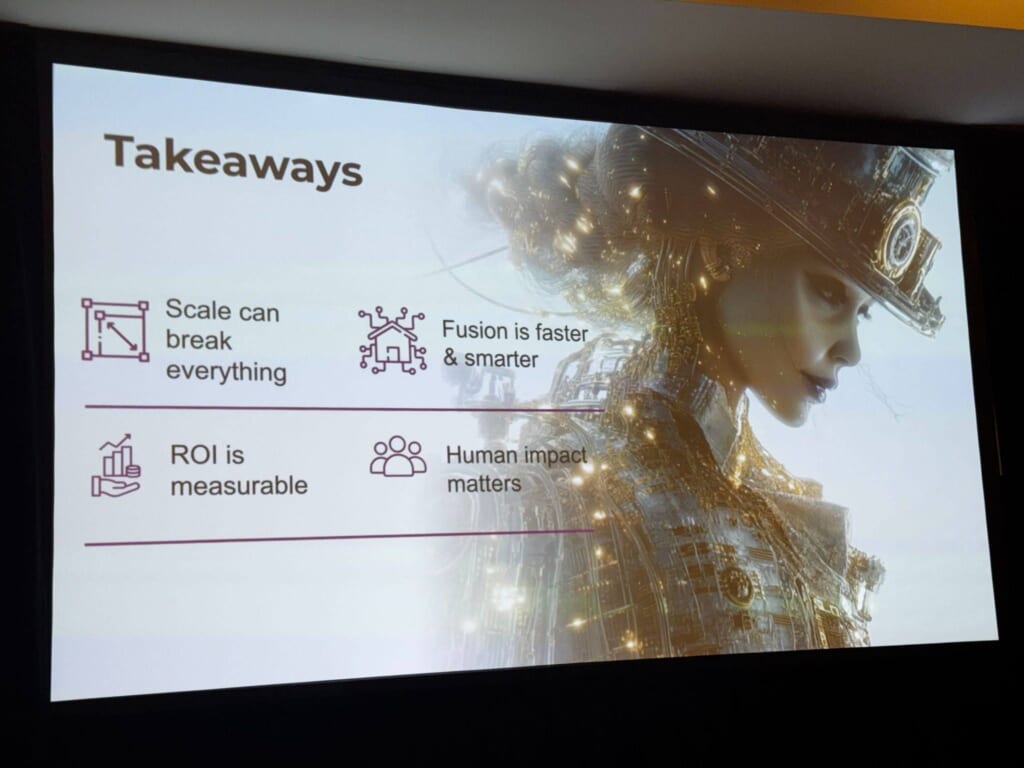
最後のまとめとして、
- (1)スケールはいつか必ず壁にぶつかる。問題はその時にどう対応するか
- (2)dbt v2は単に速いだけでなく「賢い」
- (3)ROI(投資対効果)は測定可能
- (4)そして、ツールが開発者の味方になることの「開発者へのインパクト」も見逃せない
という4点が挙げられており、技術面だけでなく現場のエンジニアの働き方そのものを変える話として締めくくられていました。
From prompt to PR: sandbox-validated dbt changes before human review
タイトルを翻訳すると「プロンプトからPRへ:サンドボックスで検証済みのdbt変更を、人間のレビュー前に」です。登壇したのは、中東の配車・配達サービス大手CareemのNiyazulla Khan Pathan氏(Data Platform Engineering Manager)とAkash Srivastava氏(Lead Software Engineer)。
Careemのデータウェアハウスチームはわずか5人で、5,000以上のETLパイプラインと100件超の同時進行リクエストを支えているそうです。
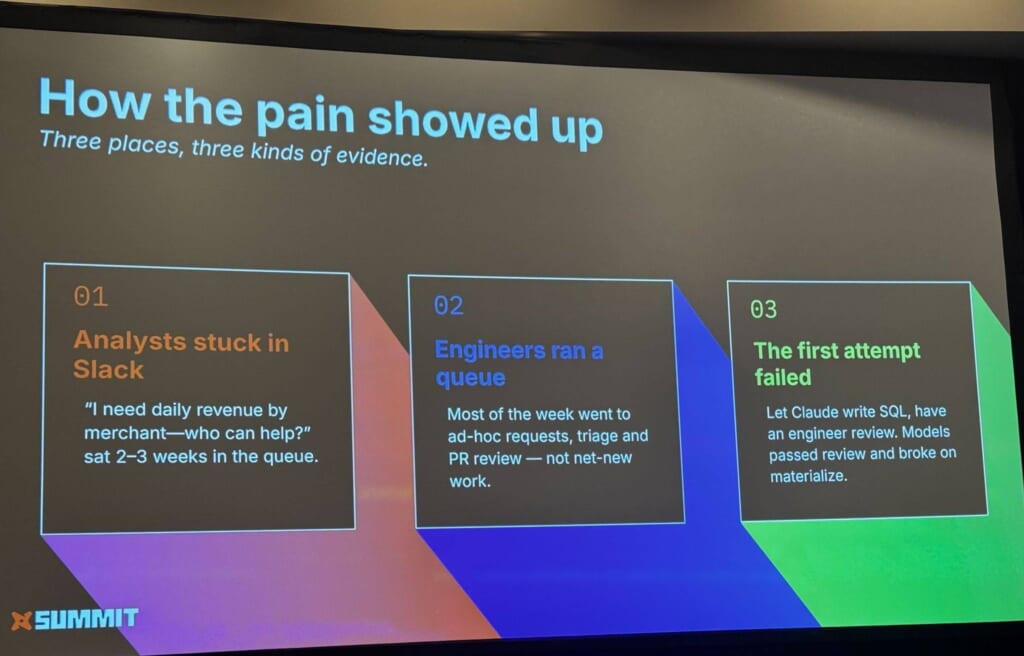
アナリストが「この指標が見たい」といったデータへのリクエストを出しても、対応してもらえるまでに2〜3週間かかる、という状態が常態化していました。
最初に試したのは「ClaudeにSQLを書かせて、エンジニアがレビューする」という素直なやり方。しかしこれは失敗に終わりました。理由はシンプルで、検証のないコード生成は、単に負担をエンジニアに移すだけだったからです。エージェントが吐き出す大量のコードを人間が一行ずつ読んでコーナーケースを洗い出すのは非現実的で、実際にレビューを通過したモデルがマテリアライズ時に壊れる、というケースも発生したそうです。
これも非常によくわかりますね。問題の箇所が移っただけです。泣ける。
このセッションで語られていた印象的なフレーズが「LLM can’t manufacture trust(LLMは信頼を作り出せない)」。コードレビューはどうしてもパターンマッチングに頼りがちで、隠れたロジックエラー(誤ったJOINやフィルター漏れ)を見抜けない。5,000以上のパイプラインが連なる環境では、たった一つの見落としが下流に連鎖し、最終的な数値の信頼性、ひいては経営陣やビジネスサイドからの信頼そのものを損なってしまう、と。
そこでCareemが構築したのが、4本柱のエージェントアーキテクチャです。
- 1.コンテキストレイヤー:
OpenMetadataを使い、テーブル/カラムの説明、リネージュ、ドメイン用語集、承認済みのKPI計算式をエージェントに提供。ハルシネーションを防ぐ土台になっている - 2.プロセス(仕様確定):
粒度・メトリクス定義・フィルター・所有権をエージェントがユーザーに確認しながら仕様をロックする - 3.インフラ(構造的ガードレール):
読み取り専用のIAMロール、devスキーマへの書き込みを強制するカスタムマクロ、Apache Kyuubiによるエフェメラルなコンピュート分離など、物理的に本番を触れない仕組み - 4.エージェントループ:
(1)コンパイル→(2)テスト→(3)マテリアライズ→(4)影響分析→(5)フィードバックという5段階の自己修正ループをサンドボックス内で回し、全て通過して初めて人間のPRレビューに進む
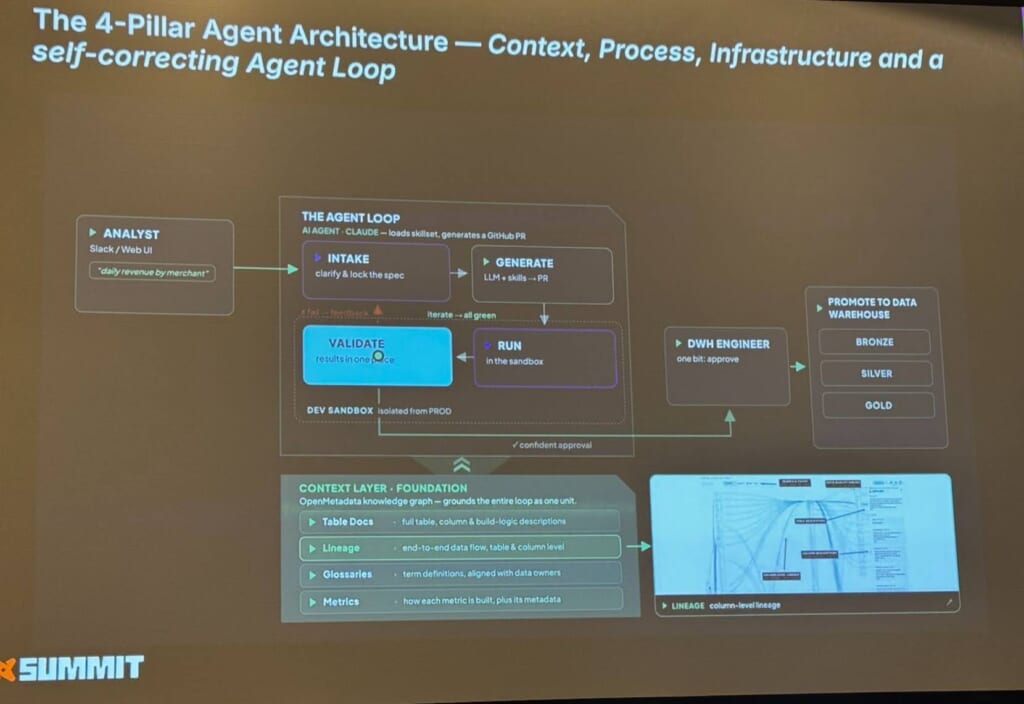
デモでは「マーチャントごとの日次食品売上が欲しい」というリクエストから、粒度の確認、SQL / YAMLの自動生成、PR作成、CIでの自動検証(最初は失敗→自己修正→成功)までを一気通貫で見せてくれました。
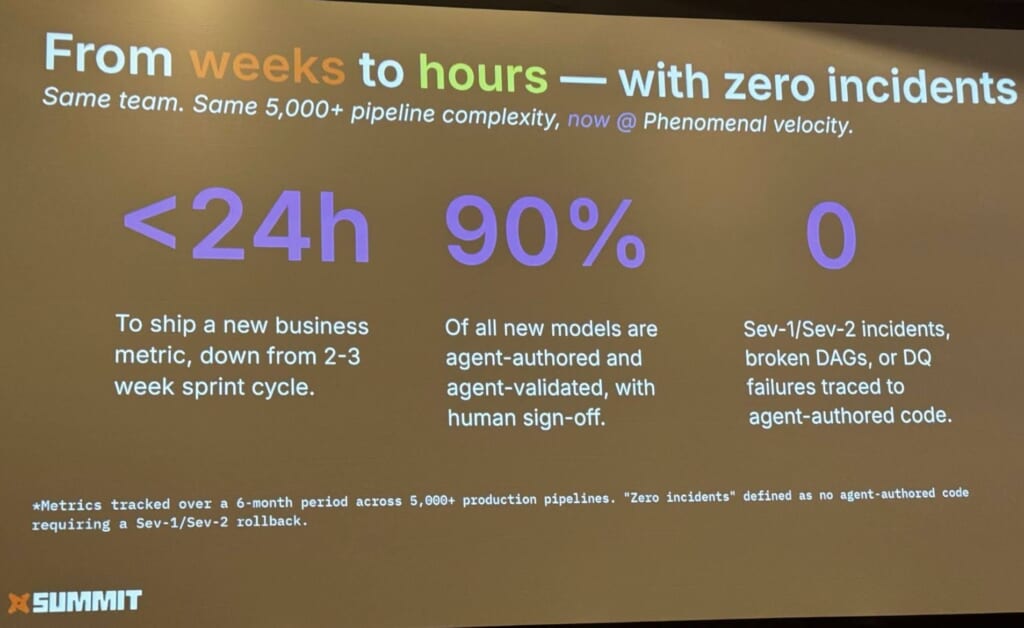
気になる成果指標はこちら(6ヶ月・5,000以上の本番パイプラインで計測)
- ・新規メトリクスの出荷時間:2〜3週間 → 24時間未満
- ・新規モデルのうちAIが作成・検証したもの:90%
- ・AI生成コードに起因するSev-1/Sev-2インシデント:0件
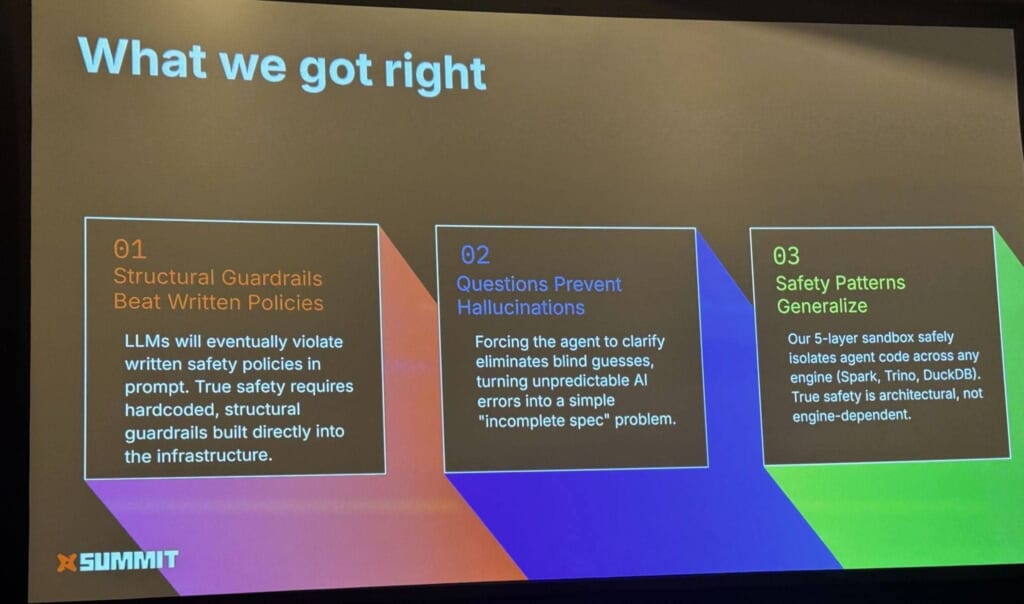
学びとして語られていたのも興味深く、「構造的ガードレールは、AI向けのポリシーに勝る」(プロンプトに安全のためのルールを書いてもLLMはいずれ逸脱するので、インフラレベルで物理的に縛る方が確実)、「エージェントに確認の質問をさせることでハルシネーションを防げる」といった点は、AIエージェントを本番運用する上で汎用的に効きそうな知見だと感じました。
一方で、暗黙知やレガシースキーマの曖昧さ、コスト影響の大きい差分処理の判断など、まだ人間の関与が必須な領域も正直に共有されていたのが好印象でした。最後のスライドの一言に集約されていたと思います。
“The generator is easy. The validation layer is the product.”
(生成器は簡単だ。検証レイヤーこそがプロダクトである)
AIにコードを書かせること自体はもはやコモディティで、本当に価値があるのは「それをどう検証し、どう信頼を担保するか」という設計だと、あらためて感じさせられるセッションでした。
まとめ
Day2で紹介した3つのセッションに共通していたのは、「AIを活かすには、その手前の基盤づくりが問われる」という点でした。Fanaticsはメトリクスのガバナンスから、Virgin Media O2はdbt Fusionによるスケール対応から、Careemは構造的ガードレールによる検証設計から、それぞれ違う切り口でこの課題に向き合っていました。
派手なAI活用事例のようでいて、実態は地に足のついた基盤整備の話だったのが、個人的には一番の学びでした。そして、基盤整備を支えるdbtの活用がポイントになってきます。
まだまだ、dbt Summit 2026は続くので、ワクワクが止まりませんね。
このページをシェアする: