dbt Summit 2026 最速レポートDay3
―セッション:各社ごとの取り組み事例―

こんにちは、DATUM STUDIOの向井です。
昨日に引き続きdbt Summit 2026 Breakout sessionのレポートをお届けします。
Beyond layers and medallions: An explicit data modeling framework
Bolt(ライドシェア / デリバリー、顧客2億人超、500超のデータセット)の事例です。ガードレールなしでdbtを導入した第1期、最初のルールを整えた第2期を経ても、ドメインごとに解釈がずれて似たようなテーブルが乱立しました。アナリティクスエンジニアが20名超になった時点で、全員の合意を経て14個の明示的なデータモデリングルールを定めました。運用約6か月で大きな問題はありません。
なお、こちらの発表資料は登壇者の方のLinkedInで公開されています。
https://www.linkedin.com/posts/siljamardla_beyond-layers-and-medallions-activity-7506709257275273216-jr31
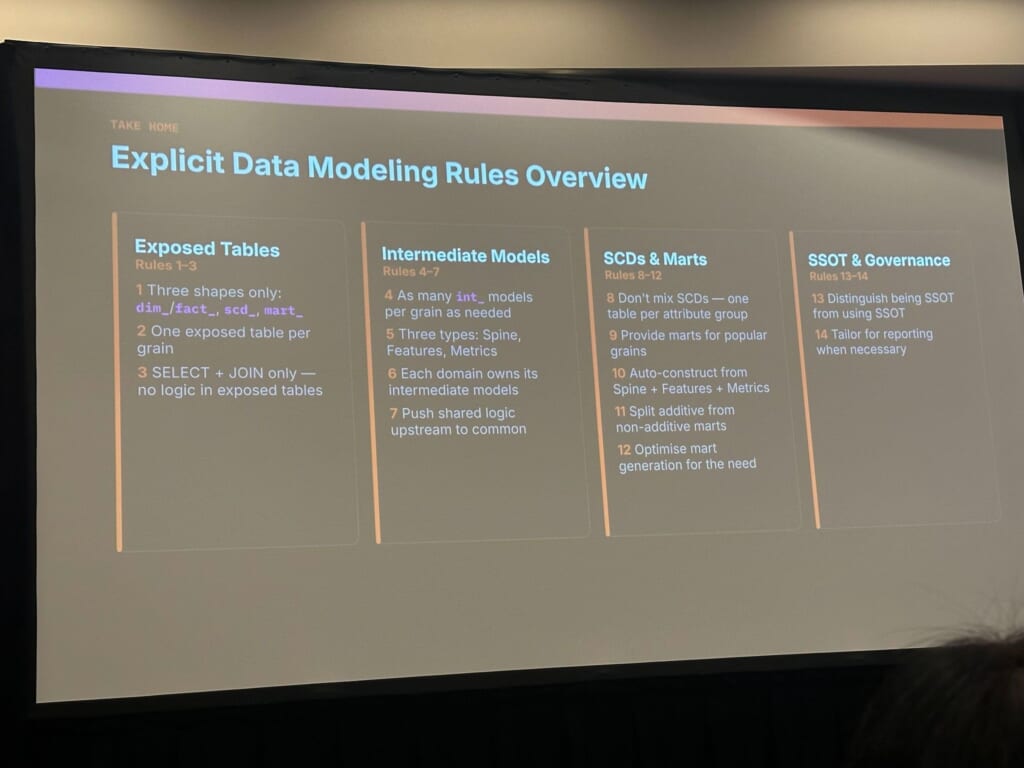
公開テーブル(ルール1〜3)
- ・形は3パターンで、単一エンティティ(`dim_` / `fact_`)、SCD(`scd_`、`valid_from` / `valid_to` 付き)、複数エンティティの組み合わせ(`mart_` / `reporting_`、例:driver × car × date)があります。テーブル名に粒度を含めます
- ・1つの粒度につき公開テーブルは1つです
- ・公開テーブルは中間モデル(`int_`)を参照したSELECT+JOINのみで、ロジックは持ちません
中間モデル(ルール4〜7)
- ・1つの粒度に対して必要なだけ作って構いません
- ・形は3つで、spine(粒度のキー+基本属性)、feature(派生属性)、metrics(粒度単位で計算した指標値)があります
- ・公開の責任は、各ドメインの中の1つのチームが担います。共有ロジックは上流の共通層へ寄せます
SCD(Slowly Changing Dimension)とマート(ルール8〜12)
- ・SCDは属性グループごとに別テーブルとします。`is_branded` と `has_insurance` のような属性を複数混ぜると有効期間が細切れになり冗長なレコードが増えます
- ・よく使う粒度にはマートを用意し、spine+feature+metricsから自動構築します。部品の時点で粒度が揃っているため公開側のロジックはゼロです
- ・加法的(count, sum)・半加法的(ratio)・非加法的(distinct count)な指標を同じマートに混ぜません
- ・自動構築の方式は用途で選びます:1本のSQL/ソーステーブルごとの `int_`(性能重視)/メトリクスごとの `int_`(数百の細いモデル)
SSOT(Single Source of Truth)とガバナンス(ルール13〜14)
- ・「SSOTである」と「SSOTを参照する」ものを区別します。最も粒度の細かいファクト上で定義した指標がSSOTです。粗い粒度のマートに再公開したものは同名・同定義・別粒度で、そのエンティティのfeatureになります
- ・再公開したfeatureは、必要に応じてレポーティング向けに調整します
複数のdbtプロジェクトを1リポジトリに置き、プロジェクト間の依存は一方向に限定します。ディレクトリはビジネスプロセス(ライド、デリバリー等)ごとに切り出します。
From DML soup to dbt structure: Ecolab’s migration story
Ecolab(水・衛生管理・感染予防ソリューションを、医療・食品など40以上の業種に提供する B2B企業)のSnowflake上のデータ基盤を、Datafoldのエージェントでdbtへ移行している途中です。移行前は最終モデル400超・データソース3,000超が相互依存し、変換ロジックはテーブルに格納され、Snowflakeタスク → JavaScriptストアドプロシージャ経由で実行されていました。小さな変更に数週間〜数か月かかり、本番障害の専任担当者が存在していたと振り返っていました。
取り組み
- ・変換ロジックをテーブルからdbtへ移し、モノリスを複数のdbtプロジェクトに分割してオーナーシップを明確化しました。dbt meshで連携し、Azure+dbt Cloudで自動テスト → ステージング → 本番のCI/CDを整備しました
- ・lift and shiftではなく、他のディメンションから参照されることで増えた相互依存関係を、ソースから設計し直します。ストリームによる差分ロードは全体方針として廃止しました(最小ウェアハウスで30〜60秒で作れるモデルを増分にする意味がないため)
- ・エージェントはリネージ・コード・要件・会議録音などの暗黙知をナレッジ化した上でレガシーコードをdbtへ翻訳し、本番サンプルデータを新旧両方のロジックで流し込み、値レベルのdata diffを取ります
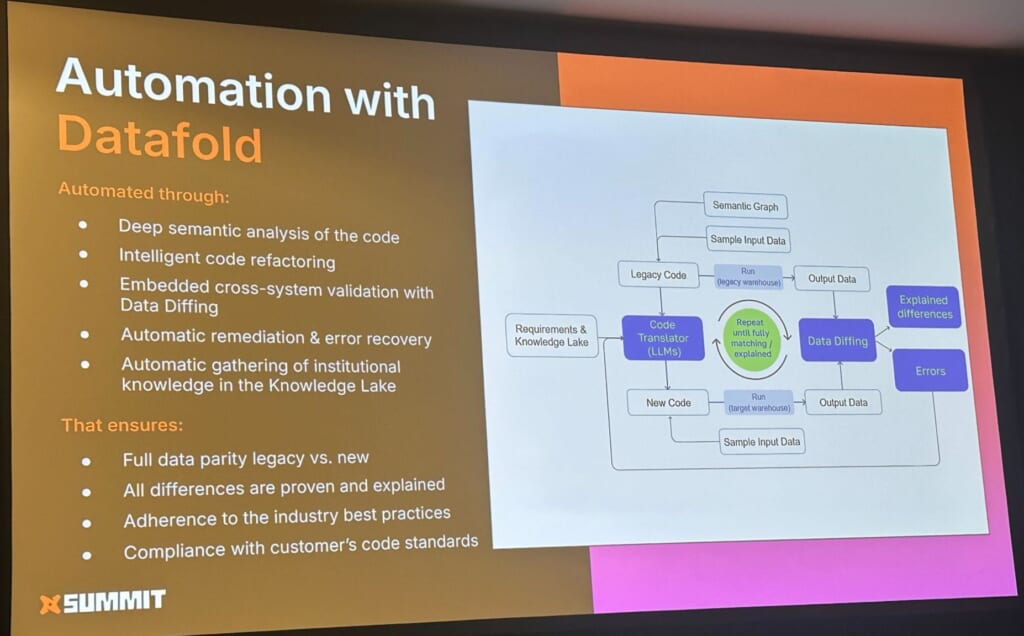
移行時にはDatafoldのエージェント機能を利用していました。lift and shiftではないため「期待される差分」が存在します。エージェントがレガシーSQL・移行後コード・要件を根拠に差分が意図通りであることを証明し、説明できない差分はエラー扱いとします。差分レポートはデータオーナーの承認にも使用します。
結果
- ・product dimensionだけで、モデル数409 → 170、コード約70,000行・データ接続約100,000を削減しました
- ・全体でコード量を1/6、データ接続を1/4に縮小しました
- ・レビューで「おかしい」と指摘された挙動が実はレガシーでも同様だったケースが複数見つかり、ビジネスとエンジニアの信頼構築につながりました
4週間で約90テーブルが承認され、副産物としてプロセス追跡・自動デプロイ・自動テストが揃い、SOC 2対応がほぼ完了しました。
教訓
- ・移行はウォーターフォールに見えて実態はアジャイルです。最初の成果物を渡した途端に命名規約や配置のレビューが大量に来ます。レガシーも移行中に変わり続けるので監視が必要です
- ・エージェントは網羅性の担保が苦手です。「全要件を満たしているか」ではなく「要件Xを満たしているか」と個別に確認する必要があります
- ・最終データに影響しない要件(見た目、保守性)は、データの正しさを確認した後に一括で適用します
- ・100%一致を期待するビジネス側に「説明された差分」を受け入れてもらうことは、技術ではなく変更管理の問題です。差分の画面を見せると納得が得られやすくなります。
今後はカットオーバー(データ利用者の切り替え、旧パイプラインの廃止)とセマンティックレイヤーの構築を進める予定だそうです。
A dbt “logic mesh” with packages: standard model and metrics across 25 autonomous organizations
Greenpeace International(データ担当10名規模)の事例です。25の独立した拠点ごとにシステム構成が異なり、計100名近くのデータ人員が同様の問い合わせに個別対応していました。「支援者」といった基本的な用語の定義すら拠点ごとにブレが生じ、集計結果が一致しない状況でした。グローバル集計は手動のデータ照会に頼り、回答までに数日を要していました。
取り組み
- ・過去にツールを5種類に絞り込む形で標準化を試みましたが、地域の個別事情(南米の決済手段等)や独自項目が急増し、各拠点で個別に変換する手法も、指標の追加ごとに25回の手作業が発生し立ち行かなくなりました。
- ・2024〜2025年にかけて Google Cloud 基盤上へdbtとTerraformを導入しました。ツール依存を避け、実務の流れに沿った共通データモデルを各拠点と協働で設計しました。
- ・この共通構造をdbtパッケージとして展開し、まずは資金調達・エンゲージメント領域から着手して他領域へ拡張できる設計としました。
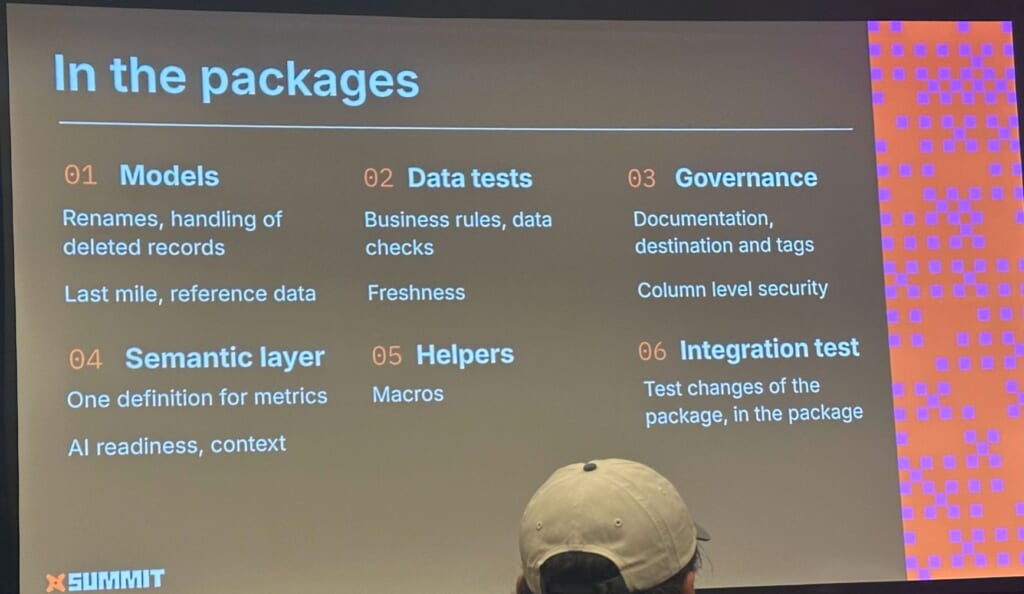
- ・パッケージ構成要素
- 1. モデル(名称整理、削除データの制御、参照データ)
- 2. データ検証(業務ルール、最新性)
- 3. ガバナンス(ドキュメント、タグ付与、列レベルの権限分離)
- 4. セマンティック層(指標の一元管理、AI活用コンテキスト)
- 5. マクロ
- 6. 変更確認テスト
- ・設計・運用ルール・DataOps・実行制御・セキュリティ・テスト基盤はプラットフォームエンジニアリングとして本部が一元提供します
結果・課題
- ・2025年Q2より順次展開を進め、全25拠点のうち14拠点において新構造への移行を完了しました
- ・最大のハードルは指標定義の調整です。25名の財務責任者それぞれに異なる定義へのこだわりがあり、最終的に定義を統一する決定権が必要となります。「寄付元」といった基本的な表現でも、すり合わせには多大な時間を要します
まとめ
各社の事例をご紹介させていただきました。今回はAIを併用した開発や移行の事例紹介が多く、当社の案件にも取り入れられそうなものがたくさんあり、とても参考になりました。
このページをシェアする: